On-premise AI for en privacy-first virksomhed: et casestudie
Et sikkerhedsrådgivningsfirma ønskede produktiviteten fra moderne AI, uden at et eneste dokument nogensinde forlod bygningen. Sådan byggede vi en privat assistent, der kører helt på deres eget hardware — og hvad det faktisk krævede.
 Have a nice day13 min. læsning
Nogle virksomheder kan ikke lægge deres data i andres cloud — ikke fordi de er paranoide, men fordi fortrolighed er selve det produkt, de sælger. Dette er historien om ét sådant firma, og hvordan vi gav dem hastigheden fra en moderne AI-assistent, uden at en eneste klientfil nogensinde forlod deres egne fire vægge. Ingen marketingglans. Bare hvad vi prøvede, hvad der brød sammen, og hvad der til sidst virkede.
Vi får en bestemt slags henvendelse et par gange om året. Den åbner som regel med en sætning som: “Vi ville rigtig gerne bruge AI, men juridisk kan vi ikke sende vores data nogen steder.” Personen i den anden ende har allerede set kolleger indsætte følsomt materiale i en offentlig chatbot, følt maven synke og stille forbudt hele kategorien. De er ikke teknologifjendtlige. De sidder fast mellem en reel produktivitetsmulighed og en tavshedspligt, der ikke er til forhandling.
Dette casestudie handler om et firma præcis som det. For at respektere netop den fortrolighed, der definerede projektet, har vi anonymiseret alt — navnet, menneskene, detaljerne om deres klienter. Tallene er illustrative og afrundede, ikke reviderede tal. Men problemets form, og måden vi løste det på, er nøjagtigt, som det skete.
Situationen: produktivitet låst bag en fortrolighedsmur
Kunden var et mellemstort rådgivningsfirma i et felt, hvor diskretion ikke er en pæn ekstra ting — det er hele grunden til, at klienter hyrer dem. Forestil dig en praksis, der håndterer følsomt virksomheds-, juridisk eller sikkerhedsnært arbejde, hvor et læk ikke bare ville være pinligt; det ville lukke forretningen. Omkring tredive personer, en tung sagsmængde og et bjerg af lange, tætte dokumenter, som nogen skal læse, opsummere og krydshenvise hver eneste uge.
Deres team havde set resten af verden accelerere med AI-assistenter og mærkede kløften vokse. En junior kunne bruge en halv dag på at hive nøglepunkter ud af en rapport på 90 sider. At udarbejde et førsteudkast til et sammendrag af en sagsmappe åd timer, som ingen fakturerede. Arbejdet var præcis den slags tætte, sprogtunge slid, som moderne AI faktisk er god til — og de kunne ikke røre noget af det.
Barrieren var enkel og absolut. Deres klientaftaler og deres egen interne politik forbød at sende klientmateriale til nogen tredjepartstjeneste. Ikke anonymiseret, ikke krypteret-i-transit, ikke “leverandøren lover ikke at træne på det.” Data måtte ikke forlade lokalerne, punktum. Ethvert cloud-AI-værktøj på markedet var udelukket per definition, uanset hvor godt dets privatlivspolitik så ud på papiret.
“De ville ikke have en leverandørs løfte om, at data var sikre. De ville have, at data aldrig kom i en position, hvor et løfte var nødvendigt.”
Den sidste distinktion opsummerer hele projektet i én sætning. Mange “privat AI”-tilbud er reelt en andens cloud med en strengere kontrakt. For denne kunde var det ikke nok. Det eneste acceptable svar var et system, hvor de følsomme data fysisk aldrig rejste — hvor man i princippet kunne trække netværkskablet ud, og assistenten stadig ville virke.
Hvorfor de oplagte cloud-svar ikke passede
Før vi byggede noget som helst, lavede vi hjemmearbejdet på de nemmere veje — for on-premise er mere arbejde, og vi vil ikke anbefale det, hvis en enklere mulighed reelt passer. For denne kunde faldt hver genvej på den samme mur.
De store udbydere tilbyder alle enterprise-niveauer med “vi træner ikke på dine data” og regional hosting. Betryggende, og for mange virksomheder fuldt ud tilstrækkeligt. Men det betyder stadig, at klientfiler forlader bygningen og ligger, om end kortvarigt, på infrastruktur, firmaet ikke kontrollerer. For en praksis, hvis kontrakter udtrykkeligt forbyder det, er et stærkt løfte stadig et løfte — og løfter overlever ikke et revisionsspørgsmål, der begynder med “kan I garantere …”.
Vi udelukkede også en privat cloud-instans — et dedikeret, isoleret miljø hostet af en udbyder. Teknisk stærkere og et helt godt match for nogle firmaer. Men det placerede stadig data på lejet hardware i en bygning, kunden ikke ejede, og det opretholdt en afhængighed af en ekstern leverandør for noget, kunden ville have helt under eget tag. De var villige til at bytte lidt bekvemmelighed for den kontrol. Så det blev on-premise.
Hvad vi faktisk byggede
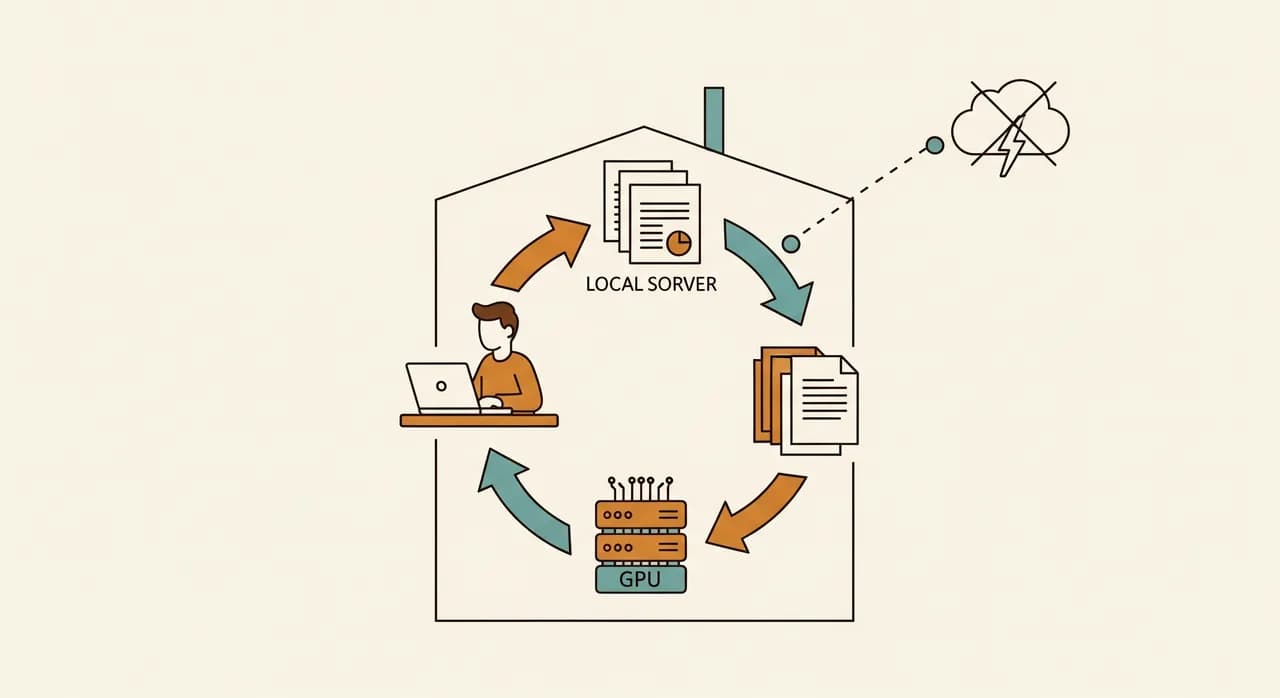
Løsningen, skrællet ind til kernen, var en privat AI-assistent, der kører på én kapabel server inde på kundens eget kontor. Teamet når den via en helt almindelig webside i deres browser — det ser ud og føles som de chatværktøjer, alle allerede kender. Bag det velkendte vindue forlader intet nogensinde det lokale netværk.
Vi holdt bevidst arkitekturen kedelig. Kedelig er pålidelig, og pålidelig er, hvad et privatlivskritisk system har brug for. Der var tre bevægelige dele værd at nævne.
En open-weight-model, der kører lokalt
I stedet for at kalde ud til en hostet model kørte vi en kapabel open-weight-sprogmodel direkte på serverens GPU. Open-weight betyder noget her: modelfilerne ligger på kundens disk, kører på kundens hardware og besvarer spørgsmål uden nogen internettur. Til deres arbejde — opsummere, udtrække, udarbejde, besvare spørgsmål om egne dokumenter — var en velvalgt mellemstor model mere end god nok. De havde ikke brug for den absolutte forkant; de havde brug for noget kompetent og privat.
Et privat videnslag over deres egne filer
Den reelle værdi var ikke en generisk chatbot — det var en assistent, der kunne besvare spørgsmål om deres egne sagsmapper. Vi byggede et fremfindingslag, der indekserer deres dokumenter lokalt, så når nogen spørger “hvad konkluderede vi om X i Müller-sagen,” finder systemet de relevante afsnit og svarer ud fra dem. Det indeks ligger, som alt andet, helt på den lokale maskine. Intet dokument, og intet fragment af ét, uploades nogensinde noget sted.
Adgangsstyring, der matchede deres eksisterende regler
Et firma som dette har allerede strenge regler for, hvem der må se hvilke filer. Assistenten skulle respektere dem, ikke ruthe uden om dem. Så adgangen spejlede deres eksisterende tilladelser: du kan kun spørge AI'en om materiale, du allerede har lov til at åbne. Det lyder oplagt, men det er den del, der gør en smart demo til noget, en compliance-ansvarlig faktisk vil skrive under på.
Hvordan vi rullede det ud uden at forstyrre arbejdet
Et privacy-first firma er, forståeligt nok, forsigtigt med nye systemer. Vi skulle ikke vinde tillid ved at vippe en kontakt og erklære sejr. Så vi kørte projektet som en række små, reversible trin, hvert bevisligt før det næste begyndte.
- 1Afgrænsede én smertefuld opgave førstVi forsøgte ikke at 'tilføje AI til firmaet.' Vi valgte ét job med højt volumen — at opsummere lange indgående dokumenter — og byggede til det. Ét klart mål, let at bedømme som succes eller fiasko.
- 2Byggede på en testmaskine med dummydataAlt blev først sat op på en isoleret maskine med opdigtede dokumenter, så ingen rigtige klientdata var involveret, før systemet var bevist og sikkerhedsmodellen gennemgået.
- 3Kørte en lukket pilot med nogle få superbrugereEn håndfuld seniormedarbejdere brugte det på rigtigt arbejde i flere uger, ved siden af deres normale proces. De fandt de ru kanter — mærkelige formuleringer, nogle dokumenter, indekset håndterede dårligt — og vi rettede dem.
- 4Vurderede det mod deres egen politikFør nogen bredere udrulning reviderede deres compliance-ansvarlige nøjagtigt, hvor data lå og bevægede sig. Fordi svaret var 'ingen steder undtagen her', var den gennemgang kort — hvilket var hele designmålet.
- 5Åbnede det for teamet med en énsides vejledningFørst da det var betroet, rullede vi det ud i hele firmaet, med et notat i klart sprog om, hvad det er godt til, hvad det ikke er, og påmindelsen om, at det aldrig finder på — det citerer.
Resultatet: timer tilbage, og intet forlod bygningen
Inden for et par måneder efter fuld udrulning var assistenten stille blevet en del af den daglige rutine. Hovedresultatet var det, de bekymrede sig mest om: ikke en eneste byte klientdata forlod nogensinde deres lokaler, og de kunne bevise det over for enhver, der spurgte. Systemet kører på deres server, på deres kontor, under deres kontrol. Alene det retfærdiggjorde projektet for dem.
Produktivitetssiden var den bonus, der gjorde det rentabelt. Førsteudkastet til sammendraget af et langt dokument — tidligere et flertimersjob for en junior — faldt til få minutters gennemgang-og-redigering. Medarbejdere holdt op med at genlæse hele filer for at besvare ét faktuelt spørgsmål; de spurgte assistenten, fik et citeret afsnit og verificerede det på sekunder. På tværs af teamet lagde den frigjorte tid sig sammen til en meningsfuld del af hver uge, omdirigeret fra at slide sig gennem dokumenter til den mere værdifulde analyse, klienterne faktisk betaler for.
Lige så sigende var en blødere forandring. Folk, der stille havde været nervøse for AI — bekymrede for, at det var et læk, der ventede på at ske — blev trygge ved at bruge det, netop fordi de forstod, hvorfor det var sikkert. Tillid kom ikke af, at vi beroligede dem. Den kom fra en arkitektur, de kunne forklare en klient i én sætning: det forlader aldrig bygningen.
| Aspekt | Før | Efter |
|---|---|---|
| Opsummere et langt dokument | En halv dag, i hånden | Minutter at gennemgå et udkast |
| Besvare et spørgsmål om en fil | Genlæse hele filen | Spørge, få et citeret afsnit |
| Hvor klientdata går hen | Bliver inde, men AI utilgængelig | Bliver inde, og AI brugbar |
| Compliance-gennemgang af værktøjet | Ville dumpe dag ét | Kort — intet forlader |
| Teamets tillid til at bruge AI | Ængstelig, mest undgået | Tryg, forstået |
“Sejren var ikke, at AI'en var kvik. Det var, at for første gang var compliance-svaret og produktivitetssvaret det samme svar.”
Hvad det kostede, ærligt talt
On-premise AI er ikke den billige mulighed, og vi ville gøre dig en bjørnetjeneste ved at lade som andet. Der er en rigtig server med en rigtig GPU at købe, et opsætningsprojekt at finansiere og løbende vedligeholdelse at budgettere til — patches, modelopdateringer, en enkelt finjustering i ny og næ. For et firma, hvis fortrolighed er kontraktlig, er den pris let at retfærdiggøre. For et firma, der bare kan lide tanken om privatliv, er den det ofte ikke, og det siger vi.
Den ærlige afvejning ser sådan ud: en højere startpris og en smule mere ansvar til gengæld for total kontrol og ingen cloud-gebyrer per besked, der skalerer med brugen. For et team med tung brug, der håndterer følsomt materiale, forbedres økonomien faktisk over tid — du har købt kapaciteten i stedet for at leje den per forespørgsel. For let eller lejlighedsvis brug ville et cloud-værktøj næsten med sikkerhed være billigere. At vide, hvilken side af den streg du er på, er det meste af beslutningen.
- En kapabel server med en egnet GPU — et engangs kapitalkøb, ikke et abonnement.
- Et opsætningsprojekt: installere og finjustere modellen, bygge dokumentindekset, koble adgangsstyring op.
- Løbende vedligeholdelse: sikkerhedspatches, modelopdateringer, lejlighedsvis genjustering, efterhånden som behov ændrer sig.
- Internt ejerskab: én navngiven person, der holder øje med det, præcis som du ville drive ethvert kernesystem.
- Ingen cloud-regning per forespørgsel — brug, der ville blive dyr i cloud'en, er reelt gratis, når hardwaren er betalt.
Ville dette passe til din virksomhed?
Dette var ikke en engangsforeteelse. Det samme mønster passer til ethvert firma, hvor datafølsomhed er begrænsningen snarere end budgettet: advokatpraksisser, medicinske og sundhedsnære udbydere, sikkerheds- og forsvarsnært arbejde, finansielle rådgivere, F&U-teams, der sidder på forretningshemmeligheder. Hvis du har grebet dig selv i at ønske AI'ens hjælp, men gyste ved tanken om, hvor data ville havne, er du den målgruppe, denne tilgang blev bygget til.
Ligeledes: hvis dine data ikke er særligt følsomme, og du bare ville betale en merpris for en følelse, peger vi dig mod en god cloud-mulighed og sparer dig for udgiften. Det rigtige svar afhænger helt af dine forpligtelser, ikke af hvilken teknologi der lyder mest imponerende. Det mest nyttige første skridt er ikke at vælge en model — det er at blive ærlig om, hvad dine fortrolighedspligter faktisk kræver.
Forhindrer fortrolighed dig i at bruge AI?
Hvis dine data juridisk ikke må forlade bygningen, har du stadig muligheder — og de er mere praktiske, end de fleste antager. Lad os se på, om en on-premise-opsætning giver mening for dine forpligtelser, uden nogen forpligtelse til at bygge noget.
Udforsk on-premise AIHyppige spørgsmål
Betyder on-premise AI, at mine data aldrig forlader bygningen?
Er en lokalt kørende model lige så god som de store cloud-modeller?
Er on-premise AI ikke meget dyrt?
Hvor lang tid tager det at sætte et sådant projekt op?
Hvem vedligeholder systemet, når det kører?
Have a nice day er et softwarestudie, der hjælper små og mellemstore virksomheder med at blive digitale — automatisering, AI og skræddersyet software, der virker i hverdagen, ikke kun på slides.