IA on-premise per uno studio vincolato alla riservatezza: un caso reale
Una società di consulenza per la sicurezza voleva la produttività dell'IA moderna senza che un solo documento uscisse mai dall'edificio. Ecco come abbiamo costruito un assistente privato che gira interamente sul loro hardware, e cosa ci è voluto davvero.
 Have a nice day14 min di lettura
Alcune aziende non possono mettere i propri dati nel cloud di qualcun altro, non per paranoia, ma perché la riservatezza è il prodotto che vendono davvero. Questa è la storia di uno studio di questo tipo, e di come gli abbiamo dato la velocità di un assistente IA moderno senza che un solo file cliente uscisse mai dalle sue quattro mura. Nessuna patina di marketing. Solo ciò che abbiamo provato, ciò che si è rotto e ciò che alla fine ha funzionato.
Riceviamo un tipo preciso di richiesta un paio di volte l'anno. Di solito comincia con una frase come: «Ci piacerebbe usare l'IA, ma per legge non possiamo inviare i nostri dati da nessuna parte.» La persona dall'altra parte ha già visto colleghi incollare materiale sensibile in un chatbot pubblico, ha avuto un tuffo al cuore e ha silenziosamente vietato l'intera categoria. Non sono contro la tecnologia. Sono bloccati tra una reale opportunità di produttività e un dovere di riservatezza non negoziabile.
Questo caso riguarda uno studio esattamente così. Per rispettare la riservatezza stessa che ha definito il progetto, abbiamo anonimizzato tutto: il nome, le persone, i dettagli dei loro clienti. I numeri sono illustrativi e arrotondati, non dati certificati. Ma la forma del problema, e il modo in cui l'abbiamo risolto, sono esattamente come sono andati.
La situazione: produttività chiusa dietro un muro di riservatezza
Il cliente era uno studio di consulenza di medie dimensioni in un settore in cui la discrezione non è un optional gradevole, ma la ragione stessa per cui i clienti lo ingaggiano. Pensate a uno studio che tratta lavoro sensibile di natura societaria, legale o affine alla sicurezza, dove una fuga di dati non sarebbe solo imbarazzante: chiuderebbe l'attività. Circa trenta persone, un carico di casi serio e una montagna di documenti lunghi e densi che qualcuno deve leggere, riassumere e incrociare ogni settimana.
Il loro team aveva visto il resto del mondo accelerare con gli assistenti IA e sentiva il divario allargarsi. Un junior poteva impiegare mezza giornata a estrarre i punti chiave da un rapporto di 90 pagine. Redigere una prima bozza di sintesi di un fascicolo divorava ore che nessuno fatturava. Il lavoro era proprio quel tipo di attività densa e carica di testo in cui l'IA moderna è davvero brava, e non potevano toccarne nulla.
Il blocco era semplice e assoluto. I loro accordi con i clienti e la loro stessa policy interna vietavano di inviare materiale dei clienti a qualsiasi servizio di terze parti. Né anonimizzato, né cifrato in transito, né «il fornitore promette di non addestrarci sopra». I dati non potevano lasciare la sede, punto. Ogni strumento di IA cloud sul mercato era escluso per definizione, per quanto bella apparisse la sua informativa sulla privacy sulla carta.
“Non volevano la promessa di un fornitore che i dati fossero al sicuro. Volevano che i dati non si trovassero mai in una posizione in cui servisse una promessa.”
Quest'ultima distinzione è l'intero progetto in una frase. Molte offerte di «IA privata» sono in realtà il cloud di qualcun altro con un contratto più severo. Per questo cliente non bastava. L'unica risposta accettabile era un sistema in cui i dati sensibili non viaggiassero mai fisicamente, uno in cui, in linea di principio, si potesse staccare il cavo di rete e l'assistente continuasse a funzionare.
Perché le ovvie soluzioni cloud non andavano bene
Prima di costruire qualsiasi cosa, abbiamo fatto la nostra due diligence sulle strade più semplici, perché l'on-premise è più lavoro e non lo raccomandiamo se un'opzione più semplice va davvero bene. Per questo cliente, ogni scorciatoia crollava contro lo stesso muro.
I grandi fornitori offrono tutti piani enterprise con «non ci addestriamo sui vostri dati» e hosting regionale. Rassicurante, e per molte aziende del tutto sufficiente. Ma significa comunque che i file dei clienti escono dall'edificio e restano, seppur brevemente, su un'infrastruttura che lo studio non controlla. Per uno studio i cui contratti lo vietano espressamente, una promessa solida resta una promessa, e le promesse non sopravvivono a una domanda di audit che inizia con «potete garantire…?».
Abbiamo anche escluso un'istanza di cloud privato: un ambiente dedicato e isolato ospitato da un fornitore. Tecnicamente più solido, e perfettamente adatto ad alcuni studi. Ma collocava comunque i dati su hardware in affitto, in un edificio che il cliente non possedeva, e manteneva una dipendenza da un fornitore esterno per qualcosa che il cliente voleva interamente sotto il proprio tetto. Era disposto a scambiare un po' di comodità per quel controllo. Così fu on-premise.
Cosa abbiamo effettivamente costruito
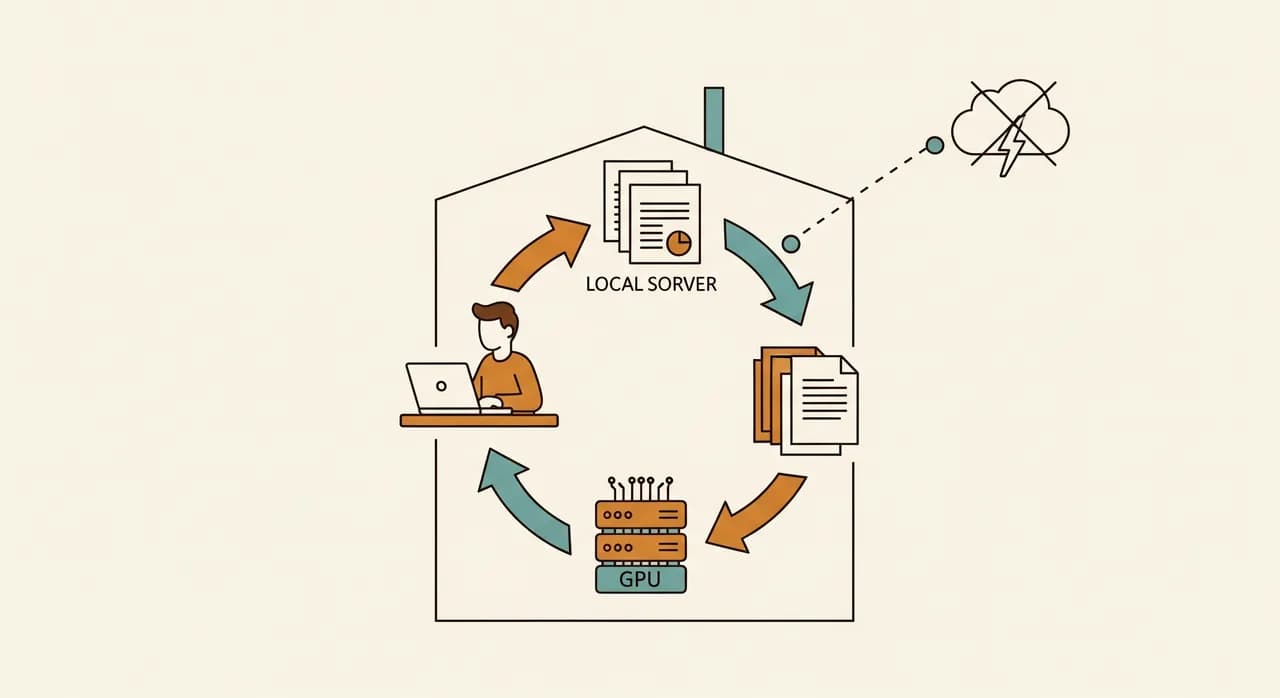
La soluzione, ridotta all'essenziale, era un assistente IA privato in esecuzione su un unico server capace all'interno dell'ufficio del cliente. Il team vi accede tramite una normale pagina web nel browser: ha l'aspetto e la sensazione degli strumenti di chat che tutti già conoscono. Dietro quella finestra familiare, nulla lascia mai la rete locale.
Abbiamo tenuto deliberatamente un'architettura noiosa. Noioso è affidabile, e affidabile è proprio ciò di cui ha bisogno un sistema critico per la privacy. C'erano tre parti in movimento che vale la pena nominare.
Un modello a pesi aperti in esecuzione in locale
Anziché richiamare un modello ospitato, abbiamo eseguito un capace modello linguistico a pesi aperti direttamente sulla GPU del server. I pesi aperti contano qui: i file del modello risiedono sul disco del cliente, girano sul suo hardware e rispondono alle domande senza alcun andata e ritorno verso internet. Per il loro carico di lavoro (riassumere, estrarre, redigere, rispondere a domande sui propri documenti) un modello di media grandezza ben scelto era più che sufficiente. Non serviva la frontiera assoluta; serviva competenza e riservatezza.
Uno strato di conoscenza privato sui loro stessi file
Il vero valore non era un chatbot generico, ma un assistente in grado di rispondere a domande sui loro stessi fascicoli. Abbiamo costruito uno strato di recupero che indicizza i loro documenti in locale, così che quando qualcuno chiede «cosa abbiamo concluso su X nella pratica Müller», il sistema trova i passaggi pertinenti e risponde a partire da essi. Quell'indice, come tutto il resto, risiede interamente sulla macchina locale. Nessun documento, né alcun frammento di esso, viene mai caricato da nessuna parte.
Un controllo degli accessi allineato alle loro regole esistenti
Uno studio del genere ha già regole rigide su chi può vedere quali file. L'assistente doveva rispettarle, non aggirarle. Così l'accesso rispecchiava i loro permessi esistenti: potete chiedere all'IA solo del materiale che avete già il diritto di aprire. Sembra ovvio, ma è la parte che trasforma una demo ingegnosa in qualcosa che un responsabile della compliance approverà davvero.
Come lo abbiamo distribuito senza interrompere il lavoro
Uno studio che mette la riservatezza al primo posto è, comprensibilmente, cauto con i nuovi sistemi. Non avremmo conquistato la fiducia premendo un interruttore e proclamando la vittoria. Così abbiamo condotto il progetto come una serie di piccoli passi reversibili, ciascuno dimostrabile prima di iniziare il successivo.
- 1Delimitare prima un compito faticosoNon abbiamo cercato di «aggiungere l'IA allo studio». Abbiamo scelto un singolo lavoro ad alto volume (riassumere i lunghi documenti in entrata) e costruito per quello. Un obiettivo chiaro, facile da giudicare come successo o fallimento.
- 2Costruire su una macchina di test con dati fittiziTutto è stato prima messo in piedi su una macchina isolata usando documenti inventati, così che nessun dato reale dei clienti è stato coinvolto finché il sistema non è stato provato e il modello di sicurezza revisionato.
- 3Condurre un pilota chiuso con pochi utenti espertiUna manciata di collaboratori senior lo ha usato su lavoro reale per diverse settimane, in parallelo al processo abituale. Hanno trovato le asperità (formulazioni strane, qualche documento gestito male dall'indice) e le abbiamo corrette.
- 4Verificarlo rispetto alla loro stessa policyPrima di qualsiasi distribuzione più ampia, il loro responsabile compliance ha verificato esattamente dove risiedevano e si spostavano i dati. Poiché la risposta era «da nessuna parte se non qui», quella revisione fu breve, il che era l'intero obiettivo del progetto.
- 5Aprirlo al team con una guida di una paginaSolo una volta guadagnata la fiducia lo abbiamo distribuito a tutto lo studio, con una nota in linguaggio semplice su cosa fa bene, cosa no, e il promemoria che non inventa mai: cita.
Il risultato: ore recuperate, e niente ha lasciato l'edificio
Nel giro di un paio di mesi dalla distribuzione completa, l'assistente era silenziosamente diventato parte della routine quotidiana. Il risultato principale fu quello a cui tenevano di più: non un solo byte di dati dei clienti ha mai lasciato la loro sede, e potevano dimostrarlo a chiunque lo chiedesse. Il sistema gira sul loro server, nel loro ufficio, sotto il loro controllo. Questo da solo giustificava il progetto ai loro occhi.
Il lato produttività fu il bonus che lo ha reso remunerativo. La prima bozza di sintesi di un lungo documento (prima un lavoro di più ore per un junior) è scesa a minuti di revisione e modifica. Il personale ha smesso di rileggere interi fascicoli per rispondere a una singola domanda fattuale; chiedevano all'assistente, ottenevano un passaggio citato e lo verificavano in secondi. Su tutto il team, il tempo liberato sommava a una parte significativa di ogni settimana, reindirizzata dal faticoso lavoro sui documenti all'analisi a maggior valore per cui i clienti pagano davvero.
Altrettanto significativo fu un cambiamento più sottile. Persone che erano rimaste silenziosamente nervose verso l'IA (temendo fosse una fuga di dati in agguato) hanno iniziato a usarla con serenità, proprio perché capivano perché fosse sicura. La fiducia non è venuta dalle nostre rassicurazioni. È venuta da un'architettura che potevano spiegare a un cliente in una frase: non lascia mai l'edificio.
| Aspetto | Prima | Dopo |
|---|---|---|
| Riassumere un lungo documento | Mezza giornata, a mano | Minuti per rivedere una bozza |
| Rispondere a una domanda su un fascicolo | Rileggere l'intero fascicolo | Chiedere, ottenere un passaggio citato |
| Dove vanno i dati dei clienti | Restano, ma IA vietata | Restano, e IA utilizzabile |
| Revisione di compliance dello strumento | Fallirebbe il primo giorno | Breve: niente esce |
| Fiducia del team nell'uso dell'IA | Ansiosa, per lo più evitata | Serena, compresa |
“La vittoria non era che l'IA fosse intelligente. Era che, per la prima volta, la risposta della compliance e la risposta della produttività erano la stessa risposta.”
Quanto è costato, onestamente
L'IA on-premise non è l'opzione economica, e vi renderemmo un cattivo servizio fingendo il contrario. C'è un vero server con una vera GPU da comprare, un progetto di setup da finanziare e una manutenzione continua da mettere a budget: patch, aggiornamenti del modello, qualche messa a punto occasionale. Per uno studio la cui riservatezza è contrattuale, quel costo è facile da giustificare. Per uno studio a cui semplicemente piace l'idea della privacy, spesso non lo è, e lo diremo.
Il compromesso onesto è questo: un costo iniziale più alto e un po' più di responsabilità in cambio del controllo totale e dell'assenza di tariffe cloud a messaggio che crescono con l'uso. Per un team a uso intenso che tratta materiale sensibile, l'economia migliora persino nel tempo: avete comprato la capacità anziché affittarla a query. Per un uso leggero od occasionale, uno strumento cloud sarebbe quasi certamente più economico. Sapere da che lato di quella linea vi trovate è la maggior parte della decisione.
- Un server capace con una GPU adatta: un acquisto in conto capitale una tantum, non un abbonamento.
- Un progetto di setup: installare e mettere a punto il modello, costruire l'indice dei documenti, cablare il controllo degli accessi.
- Manutenzione continua: patch di sicurezza, aggiornamenti del modello, occasionali ritarature al mutare delle esigenze.
- Responsabilità interna: una persona designata che lo tenga d'occhio, esattamente come per qualsiasi sistema fondamentale.
- Nessuna bolletta cloud a query: un uso che nel cloud diventerebbe costoso è di fatto gratuito una volta ripagato l'hardware.
Sarebbe adatto alla vostra azienda?
Non è stato un caso isolato. Lo stesso schema si adatta a qualsiasi studio in cui il vincolo è la sensibilità dei dati e non il budget: studi legali, fornitori medici e dell'ambito sanitario, lavoro affine a sicurezza e difesa, consulenti finanziari, team di R&S seduti su segreti industriali. Se vi siete sorpresi a desiderare l'aiuto dell'IA ma a trasalire al pensiero di dove finirebbero i dati, siete il pubblico per cui questo approccio è stato costruito.
Allo stesso modo, se i vostri dati non sono particolarmente sensibili e paghereste solo un sovrapprezzo per una sensazione, vi indicheremo una buona opzione cloud e vi risparmieremo la spesa. La risposta giusta dipende interamente dai vostri obblighi, non da quale tecnologia suona più impressionante. Il primo passo più utile non è scegliere un modello: è essere onesti su ciò che i vostri doveri di riservatezza richiedono davvero.
La riservatezza vi impedisce di usare l'IA?
Se i vostri dati per legge non possono lasciare l'edificio, avete comunque delle opzioni, e sono più pratiche di quanto la maggior parte immagini. Vediamo insieme se un setup on-premise ha senso per i vostri obblighi, senza alcun impegno a costruire nulla.
Scopri l'IA on-premiseDomande frequenti
L'IA on-premise significa che i miei dati non lasciano mai l'edificio?
Un modello eseguito in locale è buono quanto i grandi modelli cloud?
L'IA on-premise non è molto costosa?
Quanto tempo serve per allestire un progetto così?
Chi mantiene il sistema una volta in funzione?
Have a nice day è uno studio software che aiuta le piccole e medie imprese a digitalizzarsi — automazione, IA e software su misura che funziona nelle operazioni quotidiane, non solo sulle slide.