AI on-premise dla firmy stawiającej prywatność na pierwszym miejscu: studium przypadku
Firma doradcza z zakresu bezpieczeństwa chciała produktywności nowoczesnej AI bez tego, by choć jeden dokument opuścił budynek. Oto jak zbudowaliśmy prywatnego asystenta działającego w całości na ich własnym sprzęcie — i czego to naprawdę wymagało.
 Have a nice day12 min czytania
Niektóre firmy nie mogą umieścić swoich danych w cudzej chmurze — nie dlatego, że są paranoiczne, ale dlatego, że poufność to faktyczny produkt, który sprzedają. To historia jednej z takich firm i tego, jak daliśmy jej szybkość nowoczesnego asystenta AI, bez tego, by choć jeden plik klienta kiedykolwiek opuścił jej własne cztery ściany. Bez marketingowego lukru. Po prostu to, co próbowaliśmy, co się posypało i co ostatecznie zadziałało.
Kilka razy w roku dostajemy pewien szczególny rodzaj zapytania. Zwykle zaczyna się od zdania w stylu: „Bardzo chcielibyśmy używać AI, ale prawnie nie możemy nigdzie wysyłać naszych danych.” Osoba po drugiej stronie widziała już, jak koledzy wklejają wrażliwy materiał do publicznego chatbota, poczuła, jak żołądek jej się skręca, i po cichu zakazała całej kategorii. Nie są przeciwni technologii. Utknęli między realną szansą na produktywność a nienegocjowalnym obowiązkiem zachowania poufności.
To studium przypadku dotyczy dokładnie takiej firmy. Aby uszanować właśnie tę poufność, która definiowała projekt, wszystko zanonimizowaliśmy — nazwę, ludzi, szczegóły dotyczące ich klientów. Liczby są poglądowe i zaokrąglone, nie są audytowanymi wartościami. Ale kształt problemu i sposób, w jaki go rozwiązaliśmy, są dokładnie takie, jak się wydarzyły.
Sytuacja: produktywność zamknięta za murem poufności
Klientem była średniej wielkości firma doradcza w dziedzinie, w której dyskrecja nie jest miłym dodatkiem — jest całym powodem, dla którego klienci ich zatrudniają. Wyobraźcie sobie praktykę zajmującą się wrażliwą pracą korporacyjną, prawną lub okołobezpieczeństwową, gdzie wyciek nie byłby tylko żenujący; zakończyłby biznes. Około trzydziestu osób, poważne obłożenie sprawami i góra długich, gęstych dokumentów, które ktoś musi co tydzień czytać, streszczać i zestawiać ze sobą.
Ich zespół patrzył, jak reszta świata przyspiesza dzięki asystentom AI, i czuł, jak przepaść się powiększa. Młodszy pracownik mógł spędzić pół dnia, wyławiając kluczowe punkty z 90-stronicowego raportu. Sporządzenie wstępnego streszczenia akt sprawy pochłaniało godziny, których nikt nie rozliczał. Ta praca była dokładnie takim gęstym, obciążonym językiem mozołem, w którym nowoczesna AI jest naprawdę dobra — a oni nie mogli tknąć niczego z tego.
Blokada była prosta i absolutna. Ich umowy z klientami oraz własna wewnętrzna polityka zakazywały wysyłania materiałów klientów do jakiejkolwiek usługi zewnętrznej. Nie zanonimizowanych, nie szyfrowanych w tranzycie, nie „dostawca obiecuje, że nie będzie na nich trenował.” Dane nie mogły opuścić siedziby, kropka. Każde chmurowe narzędzie AI na rynku odpadało z definicji, bez względu na to, jak dobrze wyglądała jego polityka prywatności na papierze.
“Nie chcieli obietnicy dostawcy, że dane są bezpieczne. Chcieli, by dane nigdy nie znalazły się w sytuacji, w której obietnica byłaby potrzebna.”
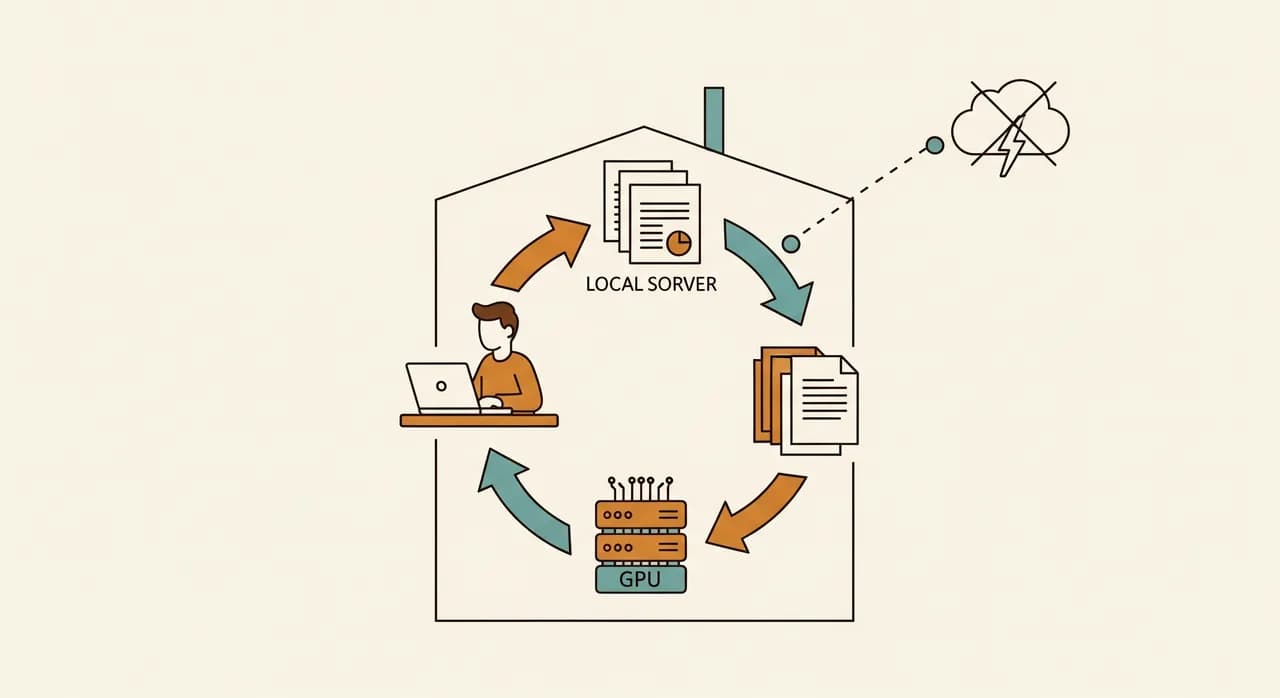
To ostatnie rozróżnienie ujmuje cały projekt w jednym zdaniu. Wiele ofert „prywatnej AI” to w rzeczywistości cudza chmura ze surowszą umową. Dla tego klienta to nie wystarczało. Jedyną akceptowalną odpowiedzią był system, w którym wrażliwe dane fizycznie nigdzie nie podróżują — w którym można by, w zasadzie, wypiąć kabel sieciowy, a asystent nadal by działał.
Dlaczego oczywiste chmurowe odpowiedzi nie pasowały
Zanim cokolwiek zbudowaliśmy, odrobiliśmy pracę domową co do łatwiejszych ścieżek — bo on-premise to więcej pracy i nie będziemy go rekomendować, jeśli prostsza opcja naprawdę pasuje. Dla tego klienta każdy skrót rozbijał się o ten sam mur.
Wielcy dostawcy oferują pakiety enterprise z „nie trenujemy na twoich danych” i regionalnym hostingiem. To uspokajające i dla wielu firm w pełni wystarczające. Ale nadal oznacza to, że pliki klientów opuszczają budynek i, choćby przez chwilę, znajdują się na infrastrukturze, której firma nie kontroluje. Dla praktyki, której umowy wprost tego zakazują, mocna obietnica pozostaje obietnicą — a obietnice nie przetrwają pytania audytowego zaczynającego się od „czy możecie zagwarantować…”.
Wykluczyliśmy też instancję chmury prywatnej — dedykowane, odizolowane środowisko hostowane przez dostawcę. Technicznie mocniejsze i całkiem dobre dla niektórych firm. Ale nadal umieszczało dane na wynajętym sprzęcie w budynku, którego klient nie był właścicielem, i utrzymywało zależność od zewnętrznego dostawcy w czymś, co klient chciał mieć w pełni pod własnym dachem. Byli gotowi poświęcić trochę wygody za tę kontrolę. Więc padło na on-premise.
Co właściwie zbudowaliśmy
Rozwiązanie, sprowadzone do sedna, to prywatny asystent AI działający na jednym wydajnym serwerze wewnątrz własnego biura klienta. Zespół sięga po niego przez zwykłą stronę internetową w przeglądarce — wygląda i działa jak narzędzia czatowe, które wszyscy już znają. Za tym znajomym oknem nic nigdy nie opuszcza sieci lokalnej.
Celowo utrzymaliśmy nudną architekturę. Nudne jest niezawodne, a niezawodne jest tym, czego potrzebuje system krytyczny dla prywatności. Były trzy elementy warte nazwania.
Model open-weight działający lokalnie
Zamiast odwoływać się do hostowanego modelu, uruchomiliśmy wydajny model językowy open-weight bezpośrednio na GPU serwera. Open-weight ma tu znaczenie: pliki modelu leżą na dysku klienta, działają na sprzęcie klienta i odpowiadają na pytania bez żadnej podróży do internetu. Do ich pracy — streszczania, ekstrakcji, redagowania, odpowiadania na pytania o własne dokumenty — dobrze dobrany model średniej wielkości był aż nadto wystarczający. Nie potrzebowali absolutnej czołówki; potrzebowali czegoś kompetentnego i prywatnego.
Prywatna warstwa wiedzy nad ich własnymi plikami
Prawdziwą wartością nie był ogólny chatbot — był to asystent, który potrafił odpowiadać na pytania o ich własnych aktach spraw. Zbudowaliśmy warstwę wyszukiwania, która lokalnie indeksuje ich dokumenty, więc gdy ktoś pyta „co wywnioskowaliśmy o X w sprawie Müllera”, system znajduje odpowiednie fragmenty i odpowiada na ich podstawie. Ten indeks, jak wszystko inne, znajduje się w całości na lokalnej maszynie. Żaden dokument ani żaden jego fragment nie jest nigdzie przesyłany.
Kontrola dostępu zgodna z ich istniejącymi regułami
Taka firma ma już ścisłe reguły dotyczące tego, kto może widzieć które pliki. Asystent musiał je respektować, a nie je obchodzić. Więc dostęp odzwierciedlał ich istniejące uprawnienia: możesz zapytać AI tylko o materiał, który już wolno ci otworzyć. Brzmi to oczywisto, ale to właśnie ta część zamienia sprytne demo w coś, pod czym inspektor ds. zgodności faktycznie się podpisze.
Jak wdrożyliśmy to bez zakłócania pracy
Firma stawiająca prywatność na pierwszym miejscu jest, co zrozumiałe, ostrożna wobec nowych systemów. Nie zamierzaliśmy zdobyć zaufania, przekręcając przełącznik i ogłaszając zwycięstwo. Więc prowadziliśmy projekt jako serię małych, odwracalnych kroków, każdy do udowodnienia, zanim zaczął się następny.
- 1Najpierw jedno bolesne zadanieNie próbowaliśmy 'dodać AI do firmy.' Wybraliśmy jedno zadanie o dużym wolumenie — streszczanie długich przychodzących dokumentów — i pod nie budowaliśmy. Jeden jasny cel, łatwy do oceny jako sukces lub porażka.
- 2Zbudowane na maszynie testowej z danymi zastępczymiWszystko najpierw postawiliśmy na odizolowanej maszynie na spreparowanych dokumentach, więc żadne prawdziwe dane klientów nie były zaangażowane, dopóki system nie został udowodniony, a model bezpieczeństwa zweryfikowany.
- 3Zamknięty pilotaż z kilkoma zaawansowanymi użytkownikamiGarstka starszych pracowników używała go przez kilka tygodni na prawdziwej pracy, obok normalnego procesu. Znaleźli chropowatości — dziwne sformułowania, kilka dokumentów, które indeks obsługiwał słabo — i je naprawiliśmy.
- 4Weryfikacja względem ich własnej politykiPrzed jakimkolwiek szerszym wdrożeniem osoba odpowiedzialna za zgodność sprawdziła dokładnie, gdzie dane się znajdują i przemieszczają. Ponieważ odpowiedź brzmiała 'nigdzie poza tym miejscem', ta kontrola była krótka — co było całym celem projektowym.
- 5Udostępnienie zespołowi z jednostronicowym przewodnikiemDopiero gdy zdobył zaufanie, wdrożyliśmy go w całej firmie, z napisaną prostym językiem notatką o tym, w czym jest dobry, w czym nie, i przypomnieniem, że nigdy nie zmyśla — cytuje.
Wynik: odzyskane godziny i nic nie opuściło budynku
W ciągu kilku miesięcy od pełnego wdrożenia asystent po cichu stał się częścią codziennej rutyny. Najważniejszym rezultatem był ten, na którym zależało im najbardziej: ani jeden bajt danych klientów nigdy nie opuścił ich siedziby, i mogli to udowodnić każdemu, kto zapytał. System działa na ich serwerze, w ich biurze, pod ich kontrolą. Samo to uzasadniało dla nich projekt.
Strona produktywności była bonusem, który sprawił, że się to opłaciło. Wstępne streszczenie długiego dokumentu — wcześniej wielogodzinne zadanie dla młodszego pracownika — spadło do kilku minut przeglądania-i-edycji. Pracownicy przestali ponownie czytać całe pliki, by odpowiedzieć na jedno pytanie o fakt; pytali asystenta, dostawali cytowany fragment i weryfikowali go w kilka sekund. W skali zespołu uwolniony czas złożył się na znaczącą część każdego tygodnia, przekierowaną z mozolenia się nad dokumentami na bardziej wartościową analizę, za którą klienci faktycznie płacą.
Równie wymowna była subtelniejsza zmiana. Ludzie, którzy po cichu obawiali się AI — w obawie, że to wyciek czekający na okazję — poczuli się z nią komfortowo, właśnie dlatego, że rozumieli, dlaczego jest bezpieczna. Zaufanie nie wzięło się z tego, że ich uspokajaliśmy. Wzięło się z architektury, którą potrafili wyjaśnić klientowi jednym zdaniem: to nigdy nie opuszcza budynku.
| Aspekt | Przed | Po |
|---|---|---|
| Streszczenie długiego dokumentu | Pół dnia, ręcznie | Minuty na przejrzenie wersji roboczej |
| Odpowiedź na pytanie o plik | Ponowne czytanie całego pliku | Zapytać, dostać cytowany fragment |
| Gdzie trafiają dane klientów | Zostają w środku, ale AI zakazana | Zostają w środku, a AI użyteczna |
| Kontrola zgodności narzędzia | Odpadłaby pierwszego dnia | Krótka — nic nie wychodzi |
| Zaufanie zespołu do AI | Niepokój, głównie unikanie | Komfort, zrozumienie |
“Wygraną nie było to, że AI była sprytna. Było to, że po raz pierwszy odpowiedź na pytanie o zgodność i odpowiedź na pytanie o produktywność były tą samą odpowiedzią.”
Ile to kosztowało, szczerze
AI on-premise nie jest tanią opcją i wyrządzilibyśmy wam krzywdę, udając inaczej. Trzeba kupić prawdziwy serwer z prawdziwym GPU, sfinansować projekt wdrożenia i zabudżetować bieżące utrzymanie — łatki, aktualizacje modelu, okazjonalne dostrojenia. Dla firmy, której poufność jest umowna, ten koszt łatwo uzasadnić. Dla firmy, której po prostu podoba się pomysł prywatności, często nie jest, i tak powiemy.
Uczciwy kompromis wygląda tak: wyższy koszt początkowy i trochę więcej odpowiedzialności w zamian za pełną kontrolę i brak chmurowych opłat za wiadomość, które rosną wraz z użyciem. Dla intensywnie korzystającego zespołu obsługującego wrażliwy materiał ekonomia z czasem wręcz się poprawia — kupiliście moc, zamiast wynajmować ją za zapytanie. Przy lekkim lub sporadycznym użyciu narzędzie chmurowe niemal na pewno byłoby tańsze. Wiedza, po której stronie tej linii jesteście, to większość decyzji.
- Wydajny serwer z odpowiednim GPU — jednorazowy zakup kapitałowy, nie subskrypcja.
- Projekt wdrożenia: instalacja i strojenie modelu, budowa indeksu dokumentów, podłączenie kontroli dostępu.
- Bieżące utrzymanie: łatki bezpieczeństwa, aktualizacje modelu, okazjonalne dostrajanie wraz ze zmianą potrzeb.
- Wewnętrzna odpowiedzialność: jedna wyznaczona osoba, która ma to na oku, dokładnie tak, jak prowadzicie każdy kluczowy system.
- Brak chmurowego rachunku za zapytanie — użycie, które w chmurze robiłoby się drogie, jest w zasadzie darmowe, gdy sprzęt jest już spłacony.
Czy to pasowałoby do waszej firmy?
To nie był jednorazowy przypadek. Ten sam wzorzec pasuje do każdej firmy, w której ograniczeniem jest wrażliwość danych, a nie budżet: kancelarie prawne, dostawcy usług medycznych i okołozdrowotnych, praca okołobezpieczeństwowa i okołoobronna, doradcy finansowi, zespoły B+R siedzące na tajemnicach handlowych. Jeśli przyłapaliście się na chęci skorzystania z pomocy AI, ale wzdragaliście się na myśl o tym, dokąd trafiłyby dane, jesteście odbiorcami, dla których to podejście zostało zbudowane.
Tak samo: jeśli wasze dane nie są szczególnie wrażliwe i płacilibyście jedynie dodatkowo za pewne poczucie, wskażemy wam dobrą opcję chmurową i oszczędzimy wam wydatku. Właściwa odpowiedź zależy w pełni od waszych zobowiązań, a nie od tego, która technologia brzmi bardziej imponująco. Najbardziej użytecznym pierwszym krokiem nie jest wybór modelu — to szczere spojrzenie na to, czego naprawdę wymagają wasze obowiązki poufności.
Poufność powstrzymuje was przed używaniem AI?
Jeśli wasze dane prawnie nie mogą opuścić budynku, wciąż macie opcje — i są one bardziej praktyczne, niż większość ludzi zakłada. Sprawdźmy razem, czy konfiguracja on-premise ma sens dla waszych zobowiązań, bez żadnego obowiązku, by cokolwiek budować.
Poznaj AI on-premiseCzęste pytania
Czy AI on-premise oznacza, że moje dane nigdy nie opuszczają budynku?
Czy model działający lokalnie jest tak dobry jak duże modele chmurowe?
Czy AI on-premise nie jest bardzo droga?
Ile trwa uruchomienie takiego projektu?
Kto utrzymuje system, gdy już działa?
Have a nice day to studio programistyczne, które pomaga małym i średnim firmom w cyfryzacji — automatyzacja, sztuczna inteligencja i oprogramowanie na zamówienie, które działa w codziennej pracy, a nie tylko na slajdach.