Локальный ИИ для фирмы, где приватность на первом месте: разбор кейса
Консалтинговая фирма в сфере безопасности хотела получить продуктивность современного ИИ так, чтобы ни один документ никогда не покидал здание. Вот как мы построили частного ассистента, работающего полностью на их собственном оборудовании — и чего это на самом деле стоило.
 Have a nice day12 мин чтения
Некоторые компании не могут положить свои данные в чужое облако — не потому что параноики, а потому что конфиденциальность и есть тот продукт, который они продают. Это история одной такой фирмы и того, как мы дали ей скорость современного ИИ-ассистента, при том что ни один клиентский файл никогда не покинул её собственные стены. Без маркетингового глянца. Только то, что мы пробовали, что ломалось и что в итоге заработало.
Несколько раз в год мы получаем особый тип запроса. Обычно он начинается с фразы вроде: «Мы бы с радостью использовали ИИ, но по закону не можем отправлять свои данные куда бы то ни было.» Человек на том конце уже видел, как коллеги вставляют чувствительный материал в публичный чат-бот, почувствовал, как ёкнуло сердце, и тихо запретил всю категорию целиком. Они не против технологий. Они застряли между реальной возможностью повысить продуктивность и не подлежащей обсуждению обязанностью хранить тайну.
Этот кейс — как раз о такой фирме. Чтобы уважить ту самую конфиденциальность, которая определила весь проект, мы анонимизировали всё — название, людей, конкретику по их клиентам. Цифры иллюстративны и округлены, это не аудированные показатели. Но форма задачи и то, как мы её решили, — ровно такие, какими они были на самом деле.
Ситуация: продуктивность за стеной конфиденциальности
Клиентом была средних размеров консультационная фирма в области, где сдержанность — не приятное дополнение, а вся причина, по которой клиенты к ним обращаются. Представьте практику, работающую с чувствительными корпоративными, юридическими или околобезопасными вопросами, где утечка была бы не просто неловкой; она бы прикончила бизнес. Около тридцати человек, серьёзная загрузка делами и гора длинных, плотных документов, которые кто-то должен каждую неделю читать, резюмировать и сверять между собой.
Их команда наблюдала, как остальной мир ускоряется с ИИ-ассистентами, и чувствовала, как разрыв растёт. Младший сотрудник мог полдня вытаскивать ключевые тезисы из 90-страничного отчёта. Подготовка первого черновика резюме по делу съедала часы, которые никто не выставлял в счёт. Работа была ровно того плотного, языкоёмкого рода, в котором современный ИИ по-настоящему хорош — а они не могли к нему прикоснуться.
Препятствие было простым и абсолютным. Их договоры с клиентами и собственная внутренняя политика запрещали передавать клиентский материал любому стороннему сервису. Ни анонимизированным, ни зашифрованным при передаче, ни под «поставщик обещает не обучаться на нём». Данным нельзя было покидать их помещения, и точка. Любой облачный ИИ-инструмент на рынке был исключён по определению, каким бы хорошим ни выглядела его политика приватности на бумаге.
“Им не нужно было обещание поставщика, что данные в безопасности. Им нужно было, чтобы данные никогда не оказывались в положении, где обещание вообще требуется.”
Это последнее различие — весь проект в одном предложении. Многие предложения «частного ИИ» на деле — чужое облако с более строгим договором. Для этого клиента этого было мало. Единственным приемлемым ответом была система, где чувствительные данные физически никогда не путешествуют — где вы могли бы, в принципе, выдернуть сетевой кабель, и ассистент продолжал бы работать.
Почему очевидные облачные варианты не подошли
Прежде чем что-либо строить, мы добросовестно проверили более простые пути — ведь on-premise — это больше работы, и мы не станем его рекомендовать, если проще решение действительно подходит. Для этого клиента каждая срезка спотыкалась об одну и ту же стену.
Крупные провайдеры все предлагают корпоративные тарифы с «мы не обучаемся на ваших данных» и региональным хостингом. Успокаивающе и для многих компаний вполне достаточно. Но это всё равно означает, что клиентские файлы покидают здание и находятся, пусть и недолго, на инфраструктуре, которую фирма не контролирует. Для практики, чьи договоры это прямо запрещают, крепкое обещание — по-прежнему лишь обещание, а обещания не переживают аудиторский вопрос, начинающийся со слов «можете ли вы гарантировать…».
Мы также отбросили вариант приватного облака — выделенной, изолированной среды, размещённой у провайдера. Технически сильнее и вполне подходящее решение для некоторых фирм. Но оно всё равно размещало данные на арендованном оборудовании в здании, которым клиент не владел, и сохраняло зависимость от внешнего поставщика в том, что клиент хотел держать полностью под собственной крышей. Они были готовы пожертвовать частью удобства ради этого контроля. Так что on-premise это и был.
Что мы на самом деле построили
Решение, сведённое к сути, — это частный ИИ-ассистент, работающий на одном мощном сервере внутри собственного офиса клиента. Команда обращается к нему через обычную веб-страницу в браузере — выглядит и ощущается как чат-инструменты, которые все уже знают. За этим привычным окном ничто никогда не покидает локальную сеть.
Мы намеренно держали архитектуру скучной. Скучное — надёжно, а надёжность — это то, что нужно системе, критичной к приватности. Стоит назвать три подвижные части.
Модель с открытыми весами, работающая локально
Вместо обращения к размещённой в облаке модели мы запустили способную языковую модель с открытыми весами прямо на GPU сервера. Открытые веса здесь важны: файлы модели живут на диске клиента, работают на оборудовании клиента и отвечают на вопросы без единого захода в интернет. Для их задач — резюмировать, извлекать, готовить черновики, отвечать на вопросы по собственным документам — хорошо подобранной модели среднего размера было более чем достаточно. Им не нужен был абсолютный передний край; им нужны были компетентность и приватность.
Частный слой знаний поверх их собственных файлов
Настоящей ценностью был не универсальный чат-бот, а ассистент, способный отвечать на вопросы по их собственным делам. Мы построили слой извлечения, который локально индексирует их документы, так что когда кто-то спрашивает «к какому выводу мы пришли по X в деле Мюллера», система находит нужные фрагменты и отвечает по ним. Этот индекс, как и всё остальное, целиком располагается на локальной машине. Ни один документ и ни один его фрагмент никогда никуда не загружается.
Контроль доступа, согласованный с их существующими правилами
У такой фирмы уже есть строгие правила о том, кто какие файлы может видеть. Ассистент должен был их соблюдать, а не обходить. Поэтому доступ зеркалил их существующие права: спрашивать ИИ можно только о материале, который вам и так разрешено открывать. Звучит очевидно, но именно эта часть превращает эффектное демо в то, что специалист по комплаенсу действительно согласует.
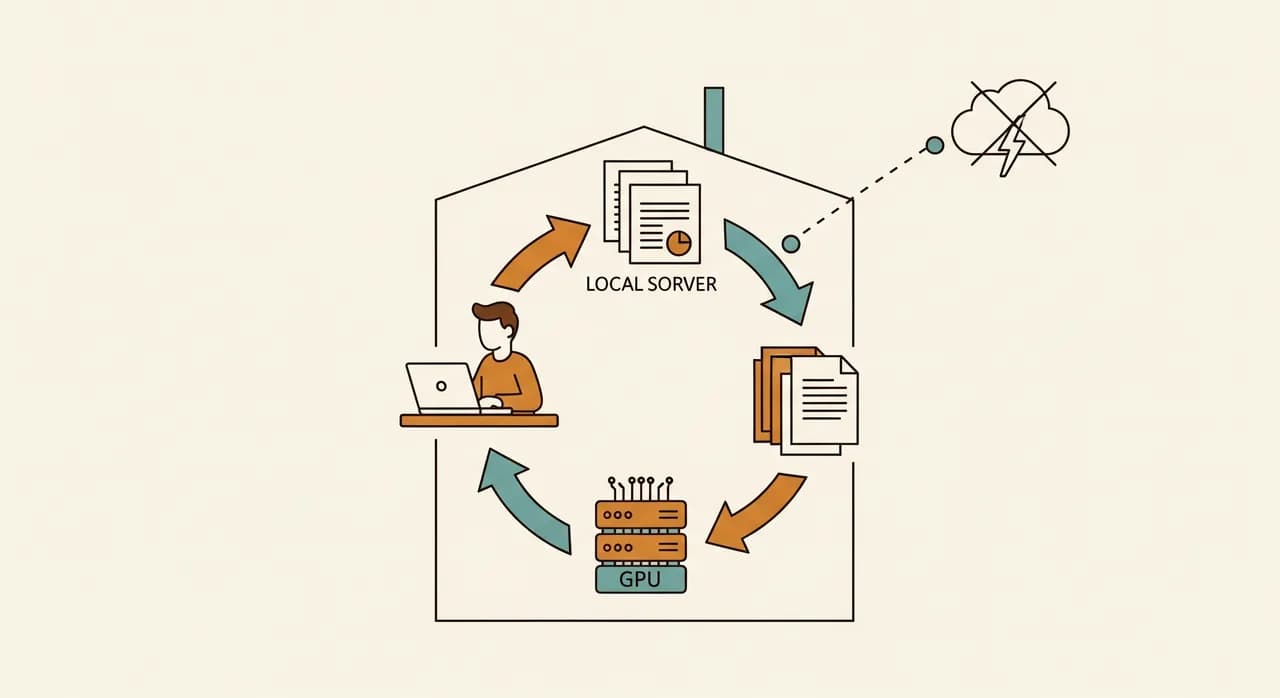
Как мы внедряли это, не мешая работе
Фирма, где приватность на первом месте, вполне понятно осторожна к новым системам. Мы не собирались завоёвывать доверие, щёлкнув переключателем и объявив победу. Поэтому мы вели проект как серию маленьких обратимых шагов, каждый из которых доказуем прежде, чем начинался следующий.
- 1Сначала очертили одну болезненную задачуМы не пытались «добавить ИИ в фирму». Мы выбрали одну высокообъёмную работу — резюмирование длинных входящих документов — и строили под неё. Одна ясная цель, которую легко оценить как успех или провал.
- 2Собрали на тестовой машине с фиктивными даннымиВсё сначала поднималось на изолированной машине на выдуманных документах, так что ни один реальный клиентский файл не был задействован, пока систему не проверили, а модель безопасности не отревьюили.
- 3Провели закрытый пилот с несколькими опытными пользователямиНесколько старших сотрудников пользовались им на реальной работе в течение нескольких недель, параллельно с обычным процессом. Они находили шероховатости — странные формулировки, пару документов, которые индекс обрабатывал плохо, — и мы их исправляли.
- 4Сверили его с их собственной политикойПеред более широким развёртыванием их руководитель по комплаенсу проверил ровно то, где данные живут и куда движутся. Поскольку ответом было «нигде, кроме как здесь», эта проверка была короткой — что и было всей целью дизайна.
- 5Открыли команде вместе с одностраничным руководствомТолько когда ему стали доверять, мы развернули его на всю фирму, приложив написанную простым языком памятку о том, в чём он хорош, в чём нет, и напоминание, что он никогда не выдумывает — он ссылается.
Результат: возвращённые часы, и ничто не покинуло здание
В течение пары месяцев после полного развёртывания ассистент тихо стал частью ежедневной рутины. Главный итог был тем, что заботил их больше всего: ни один байт клиентских данных никогда не покинул их помещения, и они могли доказать это любому, кто спросит. Система работает на их сервере, в их офисе, под их контролем. Одно это уже оправдало для них проект.
Сторона продуктивности стала бонусом, окупившим всё. Первый черновик резюме длинного документа — прежде многочасовая работа для младшего сотрудника — сократился до нескольких минут проверки и правок. Сотрудники перестали перечитывать целые файлы ради одного фактического вопроса; они спрашивали ассистента, получали цитируемый фрагмент и проверяли его за секунды. По всей команде высвободившееся время сложилось в ощутимый кусок каждой недели, перенаправленный с изматывающего продирания через документы на более ценный анализ, за который клиенты, собственно, и платят.
Не менее красноречивой была и более мягкая перемена. Люди, тихо нервничавшие из-за ИИ — опасавшиеся, что это утечка, которая только и ждёт случиться, — стали спокойно им пользоваться именно потому, что поняли, почему он безопасен. Доверие пришло не из наших заверений. Оно пришло из архитектуры, которую они могли объяснить клиенту в одном предложении: это никогда не покидает здание.
| Аспект | До | После |
|---|---|---|
| Резюмирование длинного документа | Полдня, вручную | Минуты на проверку черновика |
| Ответ на вопрос по файлу | Перечитать весь файл | Спросить, получить цитируемый фрагмент |
| Куда уходят клиентские данные | Остаются внутри, но ИИ под запретом | Остаются внутри, и ИИ можно использовать |
| Комплаенс-проверка инструмента | Провалилась бы в первый же день | Короткая — ничто не уходит |
| Уверенность команды в использовании ИИ | Тревожно, в основном избегали | Спокойно, с пониманием |
“Победа была не в том, что ИИ оказался умным. Она была в том, что впервые ответ для комплаенса и ответ для продуктивности стали одним и тем же ответом.”
Сколько это стоило, честно
On-premise ИИ — не дешёвый вариант, и мы оказали бы вам медвежью услугу, притворяясь иначе. Есть реальный сервер с реальным GPU, который нужно купить, проект внедрения, который нужно профинансировать, и текущее обслуживание, которое нужно заложить в бюджет — патчи, обновления модели, редкие подстройки. Для фирмы, чья конфиденциальность закреплена договором, эту стоимость легко оправдать. Для фирмы, которой просто нравится идея приватности, зачастую нет — и мы так и скажем.
Честный компромисс выглядит так: более высокие первоначальные затраты и чуть больше ответственности в обмен на полный контроль и отсутствие облачных платежей за каждое сообщение, растущих с использованием. Для команды с интенсивным использованием, работающей с чувствительным материалом, экономика со временем даже улучшается — вы купили мощность, а не арендуете её по запросу. Для лёгкого или редкого использования облачный инструмент почти наверняка был бы дешевле. Понимание того, на какой стороне этой черты вы находитесь, — и есть большая часть решения.
- Способный сервер с подходящим GPU — разовая капитальная покупка, а не подписка.
- Проект внедрения: установка и настройка модели, построение индекса документов, подключение контроля доступа.
- Текущее обслуживание: патчи безопасности, обновления модели, редкая перенастройка по мере изменения потребностей.
- Внутреннее владение: один назначенный человек, который присматривает за системой, ровно как вы вели бы любую ключевую систему.
- Никакого облачного счёта за запрос — использование, которое в облаке стало бы дорогим, по сути бесплатно, как только оборудование окупилось.
Подойдёт ли это вашему бизнесу?
Это был не разовый случай. Тот же паттерн подходит любой фирме, где ограничение — чувствительность данных, а не бюджет: юридическим практикам, медицинским и околоздравоохранительным поставщикам, работе в сфере безопасности и обороны, финансовым консультантам, R&D-командам, сидящим на коммерческих тайнах. Если вы ловили себя на желании воспользоваться помощью ИИ, но вздрагивали при мысли о том, куда пойдут данные, — вы та аудитория, ради которой этот подход и создавался.
Точно так же, если ваши данные не особо чувствительны и вы бы просто переплачивали за ощущение, мы направим вас к хорошему облачному варианту и сбережём вам расходы. Правильный ответ целиком зависит от ваших обязательств, а не от того, какая технология звучит внушительнее. Самый полезный первый шаг — не выбор модели, а честное осознание того, что на самом деле требуют ваши обязанности по конфиденциальности.
Конфиденциальность мешает вам пользоваться ИИ?
Если ваши данные по закону не могут покинуть здание, у вас всё равно есть варианты — и они практичнее, чем большинство предполагает. Давайте посмотрим, имеет ли смысл on-premise-решение для ваших обязательств, без обязательства что-либо строить.
Изучить on-premise ИИЧастые вопросы
Значит ли on-premise ИИ, что мои данные никогда не покидают здание?
Так ли хороша локально запущенная модель, как большие облачные?
Разве on-premise ИИ не очень дорог?
Сколько времени занимает настройка такого проекта?
Кто обслуживает систему после запуска?
Have a nice day — это софтверная студия, которая помогает малому и среднему бизнесу перейти в цифру: автоматизация, ИИ и софт под заказ, который работает в повседневных процессах, а не только на слайдах.