IA on-premise para una firma que prioriza la confidencialidad: un caso real
Una consultora de seguridad quería la productividad de la IA moderna sin que un solo documento saliera nunca del edificio. Así construimos un asistente privado que se ejecuta íntegramente en su propio hardware, y lo que realmente hizo falta.
 Have a nice day15 min de lectura
Algunas empresas no pueden poner sus datos en la nube de otro, no porque sean paranoicas, sino porque la confidencialidad es el producto que realmente venden. Esta es la historia de una firma así, y de cómo le dimos la velocidad de un asistente de IA moderno sin que un solo archivo de cliente saliera jamás de sus cuatro paredes. Sin barniz de marketing. Solo lo que probamos, lo que se rompió y lo que finalmente funcionó.
Recibimos un tipo concreto de consulta unas cuantas veces al año. Suele empezar con una frase como: «Nos encantaría usar IA, pero legalmente no podemos enviar nuestros datos a ninguna parte.» La persona al otro lado ya ha visto a colegas pegar material sensible en un chatbot público, ha sentido el vuelco en el estómago y ha prohibido en silencio toda la categoría. No están en contra de la tecnología. Están atrapados entre una oportunidad real de productividad y un deber de confidencialidad innegociable.
Este caso trata de una firma exactamente así. Para respetar la misma confidencialidad que definió el proyecto, lo hemos anonimizado todo: el nombre, las personas, los detalles de sus clientes. Las cifras son ilustrativas y redondeadas, no datos auditados. Pero la forma del problema, y el modo en que lo resolvimos, es exactamente como ocurrió.
La situación: productividad encerrada tras un muro de confidencialidad
El cliente era una consultora de tamaño medio en un campo donde la discreción no es un extra agradable, sino la razón misma por la que los clientes la contratan. Piense en un despacho que maneja trabajo corporativo, jurídico o cercano a la seguridad de carácter sensible, donde una filtración no solo sería embarazosa: acabaría con el negocio. Unas treinta personas, una carga de casos considerable y una montaña de documentos largos y densos que alguien tiene que leer, resumir y cotejar cada semana.
Su equipo había visto cómo el resto del mundo aceleraba con asistentes de IA y sentía que la brecha se ensanchaba. Un junior podía pasar media jornada extrayendo los puntos clave de un informe de 90 páginas. Redactar un primer borrador de resumen de un expediente se comía horas que nadie facturaba. El trabajo era justo ese tipo de tarea densa y cargada de texto en la que la IA moderna es realmente buena, y no podían tocar nada de ello.
El bloqueo era simple y absoluto. Sus acuerdos con clientes y su propia política interna prohibían enviar material de cliente a cualquier servicio de terceros. Ni anonimizado, ni cifrado en tránsito, ni «el proveedor promete no entrenar con ello». Los datos no podían salir de sus instalaciones, y punto. Toda herramienta de IA en la nube del mercado quedaba descartada por definición, por buena que pareciera su política de privacidad sobre el papel.
“No querían la promesa de un proveedor de que los datos estaban seguros. Querían que los datos nunca estuvieran en una posición en la que hiciera falta una promesa.”
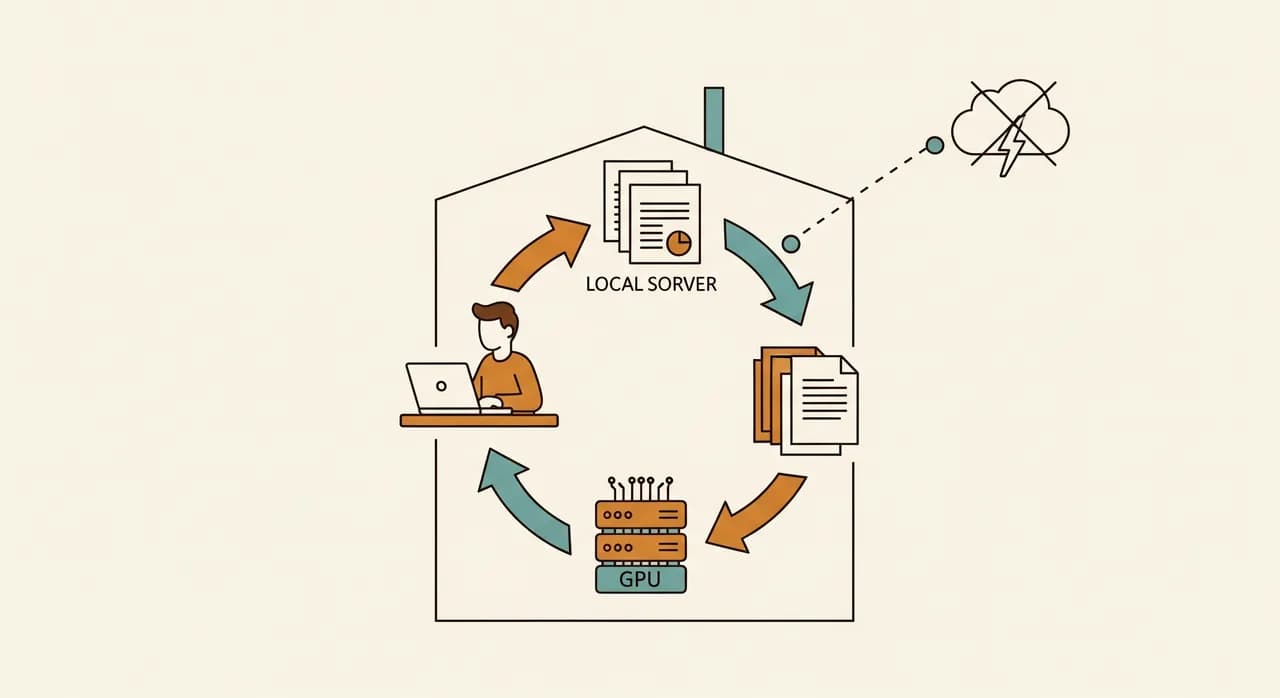
Esa última distinción es todo el proyecto en una frase. Muchas ofertas de «IA privada» son en realidad la nube de otro con un contrato más estricto. Para este cliente, eso no bastaba. La única respuesta aceptable era un sistema en el que los datos sensibles nunca viajaran físicamente, uno en el que, en principio, se pudiera desenchufar el cable de red y el asistente siguiera funcionando.
Por qué las respuestas obvias de nube no encajaban
Antes de construir nada, hicimos nuestra diligencia con los caminos más fáciles, porque on-premise es más trabajo y no lo recomendaremos si una opción más sencilla encaja de verdad. Para este cliente, cada atajo se estrellaba contra el mismo muro.
Los grandes proveedores ofrecen planes enterprise con «no entrenamos con sus datos» y alojamiento regional. Tranquilizador, y para muchas empresas totalmente suficiente. Pero sigue significando que los archivos de cliente salen del edificio y quedan, aunque sea brevemente, en una infraestructura que la firma no controla. Para un despacho cuyos contratos lo prohíben expresamente, una promesa sólida sigue siendo una promesa, y las promesas no sobreviven a una pregunta de auditoría que empieza con «¿pueden garantizar…?».
También descartamos una instancia de nube privada: un entorno dedicado y aislado alojado por un proveedor. Técnicamente más sólido y una opción perfectamente válida para algunas firmas. Pero seguía colocando los datos en hardware alquilado, en un edificio que el cliente no poseía, y mantenía una dependencia de un proveedor externo para algo que el cliente quería enteramente bajo su propio techo. Estaba dispuesto a cambiar algo de comodidad por ese control. Así que fue on-premise.
Lo que realmente construimos
La solución, reducida a lo esencial, era un asistente de IA privado que se ejecuta en un único servidor competente dentro de la propia oficina del cliente. El equipo accede a él a través de una página web corriente en su navegador: parece y se siente como las herramientas de chat que todos ya conocen. Detrás de esa ventana familiar, nada sale jamás de la red local.
Mantuvimos la arquitectura deliberadamente aburrida. Aburrido es fiable, y fiable es justo lo que necesita un sistema crítico para la privacidad. Había tres piezas móviles que vale la pena nombrar.
Un modelo de pesos abiertos ejecutándose en local
En lugar de llamar a un modelo alojado, ejecutamos un competente modelo de lenguaje de pesos abiertos directamente en la GPU del servidor. Los pesos abiertos importan aquí: los archivos del modelo viven en el disco del cliente, se ejecutan en el hardware del cliente y responden preguntas sin ningún viaje de ida y vuelta a internet. Para su carga de trabajo (resumir, extraer, redactar, responder preguntas sobre sus propios documentos) un modelo mediano bien elegido era más que suficiente. No necesitaban la frontera absoluta; necesitaban algo competente y privado.
Una capa de conocimiento privada sobre sus propios archivos
El verdadero valor no era un chatbot genérico, sino un asistente capaz de responder preguntas sobre sus propios expedientes. Construimos una capa de recuperación que indexa sus documentos en local, de modo que cuando alguien pregunta «qué concluimos sobre X en el asunto Müller», el sistema encuentra los pasajes relevantes y responde a partir de ellos. Ese índice, como todo lo demás, reside enteramente en la máquina local. Ningún documento, ni un solo fragmento de él, se sube nunca a ninguna parte.
Control de acceso ajustado a sus reglas existentes
Una firma así ya tiene reglas estrictas sobre quién puede ver qué archivos. El asistente tenía que respetarlas, no esquivarlas. Así que el acceso reflejaba sus permisos existentes: solo puede preguntar a la IA sobre material que ya tiene permitido abrir. Suena obvio, pero es la parte que convierte una demo ingeniosa en algo que un responsable de cumplimiento aprobará de verdad.
Cómo lo desplegamos sin interrumpir el trabajo
Una firma que prioriza la confidencialidad es, comprensiblemente, cautelosa con los sistemas nuevos. No íbamos a ganarnos su confianza pulsando un interruptor y proclamando la victoria. Así que llevamos el proyecto como una serie de pasos pequeños y reversibles, cada uno demostrable antes de empezar el siguiente.
- 1Primero acotamos una tarea dolorosaNo intentamos «añadir IA a la firma». Elegimos un único trabajo de alto volumen (resumir documentos largos entrantes) y construimos para eso. Un objetivo claro, fácil de juzgar como éxito o fracaso.
- 2Lo montamos en una máquina de pruebas con datos ficticiosTodo se levantó primero en una máquina aislada usando documentos inventados, de modo que no hubo datos reales de cliente hasta que el sistema quedó probado y el modelo de seguridad revisado.
- 3Ejecutamos un piloto cerrado con unos pocos usuarios avanzadosUn puñado de personas veteranas lo usó en trabajo real durante varias semanas, junto a su proceso habitual. Encontraron las asperezas (frases raras, algún documento que el índice manejaba mal) y las corregimos.
- 4Lo revisamos contra su propia políticaAntes de cualquier despliegue más amplio, su responsable de cumplimiento auditó exactamente dónde residían y se movían los datos. Como la respuesta era «en ningún sitio salvo aquí», esa revisión fue breve, que era todo el objetivo del diseño.
- 5Lo abrimos al equipo con una guía de una páginaSolo cuando ya gozaba de confianza lo desplegamos en toda la firma, con una nota en lenguaje llano sobre en qué es bueno, en qué no, y el recordatorio de que nunca inventa: cita.
El resultado: horas recuperadas, y nada salió del edificio
En un par de meses tras el despliegue completo, el asistente se había convertido en silencio en parte de la rutina diaria. El resultado destacado fue el que más les importaba: ni un solo byte de datos de cliente salió jamás de sus instalaciones, y podían demostrárselo a quien lo preguntara. El sistema corre en su servidor, en su oficina, bajo su control. Solo eso ya justificaba el proyecto para ellos.
El lado de la productividad fue el extra que lo hizo rentable. El primer borrador de resumen de un documento largo (antes una tarea de varias horas para un junior) bajó a minutos de revisar y editar. El personal dejó de releer expedientes enteros para responder una sola pregunta factual; preguntaban al asistente, obtenían un pasaje citado y lo verificaban en segundos. En todo el equipo, el tiempo liberado sumaba una parte considerable de cada semana, redirigida de pelearse con documentos al análisis de mayor valor por el que los clientes de verdad pagan.
Igual de revelador fue un cambio más sutil. Personas que habían estado calladamente nerviosas con la IA (temían que fuera una filtración a punto de suceder) pasaron a usarla con comodidad, precisamente porque entendían por qué era segura. La confianza no vino de que las tranquilizáramos. Vino de una arquitectura que podían explicar a un cliente en una frase: nunca sale del edificio.
| Aspecto | Antes | Después |
|---|---|---|
| Resumir un documento largo | Media jornada, a mano | Minutos para revisar un borrador |
| Responder una pregunta sobre un expediente | Releer el expediente entero | Preguntar, obtener un pasaje citado |
| Adónde van los datos de cliente | Se quedan, pero la IA vetada | Se quedan, y la IA es usable |
| Revisión de cumplimiento de la herramienta | Suspendería el primer día | Breve: nada sale |
| Confianza del equipo al usar IA | Inquieta, se evitaba | Cómoda, comprendida |
“El logro no fue que la IA fuera lista. Fue que, por primera vez, la respuesta de cumplimiento y la respuesta de productividad eran la misma respuesta.”
Lo que costó, con honestidad
La IA on-premise no es la opción barata, y le haríamos un flaco favor fingiendo lo contrario. Hay un servidor real con una GPU real que comprar, un proyecto de montaje que financiar y un mantenimiento continuo que presupuestar: parches, actualizaciones de modelo, algún ajuste ocasional. Para una firma cuya confidencialidad es contractual, ese coste es fácil de justificar. Para una firma a la que simplemente le gusta la idea de la privacidad, a menudo no lo es, y lo diremos.
El compromiso honesto es este: un coste inicial más alto y algo más de responsabilidad a cambio de control total y de no pagar tarifas de nube por mensaje que escalan con el uso. Para un equipo de uso intensivo que maneja material sensible, la economía incluso mejora con el tiempo: ha comprado la capacidad en lugar de alquilarla por consulta. Para un uso ligero u ocasional, una herramienta en la nube casi con seguridad saldría más barata. Saber en qué lado de esa línea está es la mayor parte de la decisión.
- Un servidor competente con una GPU adecuada: una compra de capital única, no una suscripción.
- Un proyecto de montaje: instalar y ajustar el modelo, construir el índice de documentos, cablear el control de acceso.
- Mantenimiento continuo: parches de seguridad, actualizaciones de modelo, reajustes ocasionales según cambien las necesidades.
- Responsabilidad interna: una persona designada que lo vigile, igual que haría con cualquier sistema esencial.
- Sin factura de nube por consulta: el uso que sería caro en la nube resulta prácticamente gratuito una vez pagado el hardware.
¿Encajaría esto en su empresa?
No fue un caso único. El mismo patrón encaja en cualquier firma donde la restricción sea la sensibilidad de los datos y no el presupuesto: despachos jurídicos, proveedores médicos y del ámbito sanitario, trabajo cercano a la seguridad y la defensa, asesores financieros, equipos de I+D sentados sobre secretos comerciales. Si se ha sorprendido queriendo la ayuda de la IA pero encogiéndose ante la idea de adónde irían los datos, usted es el público para el que se construyó este enfoque.
Del mismo modo, si sus datos no son especialmente sensibles y solo pagaría un sobreprecio por una sensación, le señalaremos una buena opción en la nube y le ahorraremos el gasto. La respuesta correcta depende enteramente de sus obligaciones, no de qué tecnología suena más impresionante. El primer paso más útil no es elegir un modelo: es ser honesto sobre lo que sus deberes de confidencialidad realmente exigen.
¿La confidencialidad le impide usar IA?
Si sus datos legalmente no pueden salir del edificio, aún tiene opciones, y son más prácticas de lo que la mayoría supone. Veamos si un montaje on-premise tiene sentido para sus obligaciones, sin compromiso alguno de construir nada.
Descubrir la IA on-premisePreguntas frecuentes
¿La IA on-premise significa que mis datos nunca salen del edificio?
¿Un modelo ejecutado en local es tan bueno como los grandes de la nube?
¿No es muy cara la IA on-premise?
¿Cuánto tarda en montarse un proyecto así?
¿Quién mantiene el sistema una vez en marcha?
Have a nice day es un estudio de software que ayuda a las pequeñas y medianas empresas a digitalizarse — automatización, IA y software a medida que funciona en el día a día, no solo en las diapositivas.