On-premise AI för en integritetsfokuserad firma: en fallstudie
En säkerhetskonsultfirma ville ha produktiviteten från modern AI utan att ett enda dokument någonsin lämnade byggnaden. Så här byggde vi en privat assistent som körs helt på deras egen hårdvara — och vad det faktiskt krävde.
 Have a nice day13 min läsning
Vissa företag kan inte lägga sin data i någon annans moln — inte för att de är paranoida, utan för att sekretess är själva produkten de säljer. Detta är berättelsen om en sådan firma, och hur vi gav dem hastigheten hos en modern AI-assistent utan att en enda klientfil någonsin lämnade deras egna fyra väggar. Ingen marknadsföringsglans. Bara vad vi provade, vad som gick sönder och vad som till slut fungerade.
Vi får en särskild sorts förfrågan några gånger om året. Den inleds oftast med en mening som: ”Vi skulle jättegärna använda AI, men juridiskt får vi inte skicka vår data någonstans.” Personen i andra änden har redan sett kollegor klistra in känsligt material i en publik chatbot, känt magen sjunka och tyst förbjudit hela kategorin. De är inte teknikfientliga. De sitter fast mellan en verklig produktivitetsmöjlighet och en tystnadsplikt som inte går att förhandla om.
Den här fallstudien handlar om en firma precis som den. För att respektera just den sekretess som definierade projektet har vi anonymiserat allt — namnet, människorna, detaljerna om deras klienter. Siffrorna är illustrativa och avrundade, inte reviderade tal. Men problemets form, och sättet vi löste det på, är exakt som det gick till.
Situationen: produktivitet inlåst bakom en sekretessmur
Kunden var en medelstor rådgivningsfirma i ett fält där diskretion inte är ett trevligt tillägg — det är hela anledningen till att klienter anlitar dem. Tänk dig en verksamhet som hanterar känsligt företags-, juridiskt eller säkerhetsnära arbete, där en läcka inte bara vore pinsam; den vore slutet för verksamheten. Ett trettiotal personer, en tung ärendemängd och ett berg av långa, täta dokument som någon måste läsa, sammanfatta och korsreferera varje enskild vecka.
Deras team hade sett resten av världen accelerera med AI-assistenter och kände klyftan vidgas. En junior kunde lägga en halv dag på att gräva fram nyckelpunkter ur en 90-sidig rapport. Att skriva ett första utkast till en sammanfattning av en akt åt upp timmar som ingen fakturerade. Arbetet var precis den sorts täta, språktunga slit som modern AI faktiskt är bra på — och de fick inte röra något av det.
Hindret var enkelt och absolut. Deras klientavtal och deras egen interna policy förbjöd att skicka klientmaterial till någon tredjepartstjänst. Inte anonymiserat, inte krypterat-i-transit, inte ”leverantören lovar att inte träna på det.” Datan fick inte lämna lokalerna, punkt slut. Varje moln-AI-verktyg på marknaden var uteslutet per definition, oavsett hur bra dess integritetspolicy såg ut på papperet.
“De ville inte ha en leverantörs löfte om att datan var säker. De ville att datan aldrig skulle hamna i ett läge där ett löfte behövdes.”
Den sista distinktionen sammanfattar hela projektet i en mening. Många ”privat AI”-erbjudanden är egentligen någon annans moln med ett strängare avtal. För den här kunden räckte inte det. Det enda godtagbara svaret var ett system där den känsliga datan fysiskt aldrig färdades — där man i princip kunde dra ur nätverkskabeln och assistenten ändå skulle fungera.
Varför de självklara molnsvaren inte passade
Innan vi byggde något gjorde vi vår hemläxa på de enklare vägarna — för on-premise är mer arbete, och vi rekommenderar det inte om ett enklare alternativ verkligen passar. För den här kunden föll varje genväg på samma mur.
De stora leverantörerna erbjuder alla enterprise-nivåer med ”vi tränar inte på din data” och regional hosting. Betryggande, och för många företag helt tillräckligt. Men det innebär fortfarande att klientfiler lämnar byggnaden och ligger, om än kort, på infrastruktur som firman inte kontrollerar. För en verksamhet vars avtal uttryckligen förbjuder det är ett starkt löfte fortfarande ett löfte — och löften överlever inte en revisionsfråga som börjar med ”kan ni garantera …”.
Vi uteslöt också en privat molninstans — en dedikerad, isolerad miljö som en leverantör hostar. Tekniskt starkare, och en fullt god lösning för vissa firmor. Men det placerade ändå datan på hyrd hårdvara i en byggnad kunden inte ägde, och det behöll ett beroende av en extern leverantör för något kunden ville ha helt under eget tak. De var villiga att byta lite bekvämlighet mot den kontrollen. Så det blev on-premise.
Vad vi faktiskt byggde
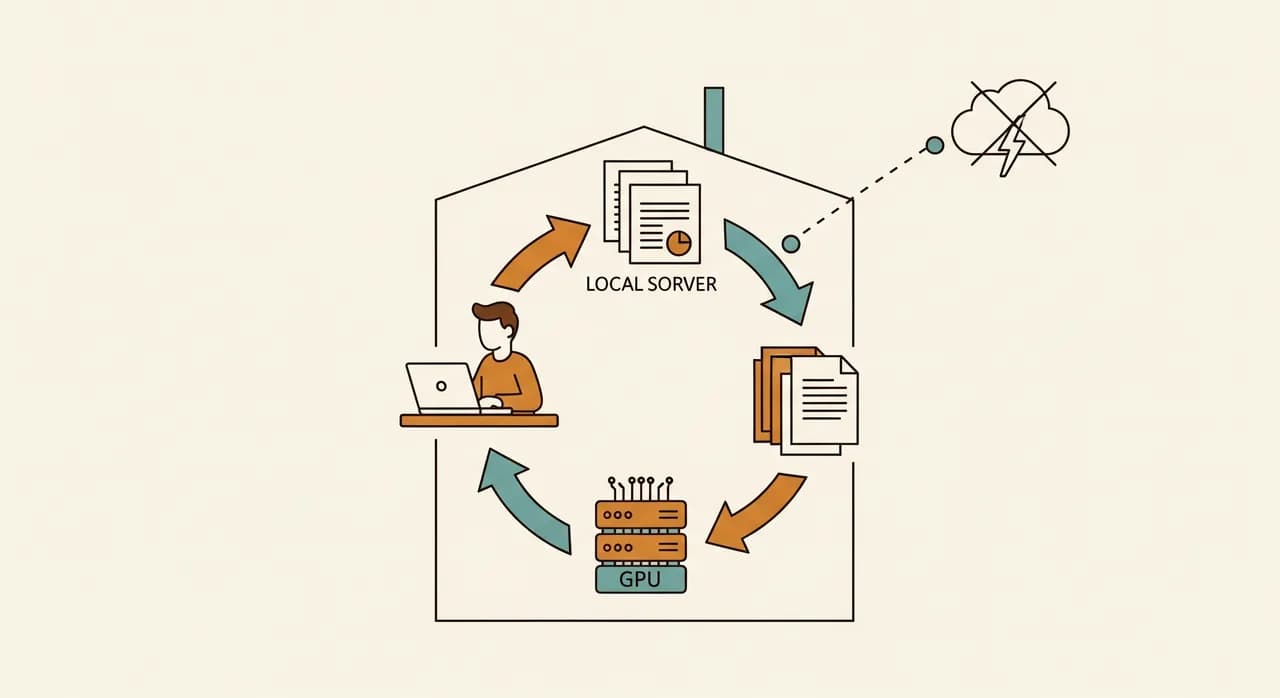
Lösningen, nedskalad till det väsentliga, var en privat AI-assistent som körs på en enda kapabel server inne på kundens eget kontor. Teamet når den via en helt vanlig webbsida i sin webbläsare — det ser ut och känns som chattverktygen alla redan känner till. Bakom det välbekanta fönstret lämnar aldrig något det lokala nätverket.
Vi höll medvetet arkitekturen tråkig. Tråkigt är pålitligt, och pålitligt är vad ett integritetskritiskt system behöver. Det fanns tre rörliga delar värda att nämna.
En open-weight-modell som körs lokalt
I stället för att anropa en hostad modell körde vi en kapabel open-weight-språkmodell direkt på serverns GPU. Open-weight spelar roll här: modellfilerna ligger på kundens disk, körs på kundens hårdvara och besvarar frågor utan någon internetresa. För deras arbete — sammanfatta, extrahera, utforma, besvara frågor om egna dokument — var en välvald mellanstor modell mer än tillräckligt bra. De behövde inte den absoluta framkanten; de behövde något kompetent och privat.
Ett privat kunskapslager över deras egna filer
Det verkliga värdet var inte en generisk chatbot — det var en assistent som kunde besvara frågor om deras egna akter. Vi byggde ett hämtningslager som indexerar deras dokument lokalt, så att när någon frågar ”vad drog vi för slutsats om X i Müller-ärendet” hittar systemet de relevanta styckena och svarar utifrån dem. Det indexet ligger, liksom allt annat, helt på den lokala maskinen. Inget dokument, och inget fragment av ett, laddas någonsin upp någonstans.
Åtkomststyrning som matchade deras befintliga regler
En firma som denna har redan strikta regler för vem som får se vilka filer. Assistenten måste respektera dem, inte gå runt dem. Så åtkomsten speglade deras befintliga behörigheter: du kan bara fråga AI:n om material du redan har rätt att öppna. Det låter självklart, men det är den del som förvandlar en smart demo till något en compliance-ansvarig faktiskt vill skriva under på.
Hur vi rullade ut det utan att störa arbetet
En integritetsfokuserad firma är, förståeligt nog, försiktig med nya system. Vi tänkte inte vinna förtroende genom att slå på en strömbrytare och utropa seger. Så vi drev projektet som en rad små, reversibla steg, vart och ett bevisbart innan nästa började.
- 1Avgränsade en smärtsam uppgift förstVi försökte inte 'lägga till AI i firman.' Vi valde ett enda jobb med hög volym — att sammanfatta långa inkommande dokument — och byggde för det. Ett tydligt mål, lätt att bedöma som framgång eller misslyckande.
- 2Byggde på en testmaskin med dummydataAllt sattes först upp på en isolerad maskin med påhittade dokument, så att ingen riktig klientdata var inblandad förrän systemet var bevisat och säkerhetsmodellen granskad.
- 3Körde en sluten pilot med några superanvändareEn handfull seniora medarbetare använde det på riktigt arbete i flera veckor, vid sidan av sin normala process. De hittade de skrovliga kanterna — konstiga formuleringar, några dokument som indexet hanterade dåligt — och vi rättade dem.
- 4Granskade det mot deras egen policyFöre någon bredare utrullning granskade deras compliance-ansvariga exakt var data låg och rörde sig. Eftersom svaret var 'ingenstans utom här' blev den granskningen kort — vilket var hela designmålet.
- 5Öppnade det för teamet med en ensidig guideFörst när det var betrott rullade vi ut det i hela firman, med en anteckning i klarspråk om vad det är bra på, vad det inte är, och påminnelsen om att det aldrig hittar på — det citerar.
Resultatet: timmar tillbaka, och inget lämnade byggnaden
Inom ett par månader efter full utrullning hade assistenten tyst blivit en del av den dagliga rutinen. Huvudresultatet var det de brydde sig mest om: inte en enda byte klientdata lämnade någonsin deras lokaler, och de kunde bevisa det för vem som helst som frågade. Systemet körs på deras server, på deras kontor, under deras kontroll. Enbart det rättfärdigade projektet för dem.
Produktivitetssidan var bonusen som gjorde det lönsamt. Första utkastet till sammanfattningen av ett långt dokument — tidigare ett flertimmarsjobb för en junior — sjönk till några minuters genomläsning-och-redigering. Medarbetare slutade läsa om hela filer för att besvara en enda faktafråga; de frågade assistenten, fick ett citerat stycke och verifierade det på sekunder. Över hela teamet summerade den frigjorda tiden till en meningsfull del av varje vecka, omdirigerad från att slita sig igenom dokument till den mer värdefulla analys som klienterna faktiskt betalar för.
Lika talande var en mjukare förändring. Människor som tyst hade varit nervösa för AI — oroliga att det var en läcka som väntade på att hända — blev bekväma med att använda det, just för att de förstod varför det var säkert. Förtroendet kom inte av att vi lugnade dem. Det kom från en arkitektur de kunde förklara för en klient i en mening: det lämnar aldrig byggnaden.
| Aspekt | Före | Efter |
|---|---|---|
| Sammanfatta ett långt dokument | En halv dag, för hand | Minuter att granska ett utkast |
| Besvara en fråga om en fil | Läsa om hela filen | Fråga, få ett citerat stycke |
| Vart klientdata tar vägen | Stannar inne, men AI otillåten | Stannar inne, och AI användbar |
| Compliance-granskning av verktyget | Skulle underkännas dag ett | Kort — inget lämnar |
| Teamets tillit till att använda AI | Ängslig, mest undviken | Bekväm, förstådd |
“Vinsten var inte att AI:n var smart. Det var att, för första gången, compliance-svaret och produktivitetssvaret var samma svar.”
Vad det kostade, ärligt talat
On-premise AI är inte det billiga alternativet, och vi vore dig en björntjänst att låtsas annat. Det finns en riktig server med en riktig GPU att köpa, ett uppsättningsprojekt att finansiera och löpande underhåll att budgetera för — patchar, modelluppdateringar, en och annan finjustering. För en firma vars sekretess är avtalsmässig är den kostnaden lätt att rättfärdiga. För en firma som bara gillar tanken på integritet är den ofta inte det, och det säger vi.
Den ärliga avvägningen ser ut så här: en högre startkostnad och lite mer ansvar i utbyte mot total kontroll och inga molnavgifter per meddelande som skalar med användningen. För ett team med tung användning som hanterar känsligt material förbättras ekonomin faktiskt över tid — du har köpt kapaciteten i stället för att hyra den per fråga. För lätt eller sporadisk användning vore ett molnverktyg nästan säkert billigare. Att veta vilken sida av den linjen du är på är det mesta av beslutet.
- En kapabel server med en lämplig GPU — ett engångs kapitalköp, inte en prenumeration.
- Ett uppsättningsprojekt: installera och finjustera modellen, bygga dokumentindexet, koppla upp åtkomststyrning.
- Löpande underhåll: säkerhetspatchar, modelluppdateringar, enstaka omjusteringar när behoven ändras.
- Internt ägarskap: en utsedd person som håller ett öga på det, precis som du skulle driva vilket kärnsystem som helst.
- Ingen molnräkning per fråga — användning som skulle bli dyr i molnet är i praktiken gratis när hårdvaran är betald.
Skulle detta passa ditt företag?
Detta var inte en engångsföreteelse. Samma mönster passar vilken firma som helst där datakänslighet är begränsningen snarare än budgeten: advokatbyråer, medicinska och hälsonära leverantörer, säkerhets- och försvarsnära arbete, finansiella rådgivare, FoU-team som sitter på affärshemligheter. Om du har kommit på dig själv med att vilja ha AI:s hjälp men ryggat tillbaka vid tanken på vart datan skulle ta vägen, är du målgruppen som den här ansatsen byggdes för.
Likaså: om din data inte är särskilt känslig och du bara skulle betala en premie för en känsla, pekar vi dig mot ett bra molnalternativ och sparar dig utgiften. Rätt svar beror helt på dina förpliktelser, inte på vilken teknik som låter mest imponerande. Det mest användbara första steget är inte att välja en modell — det är att bli ärlig om vad dina sekretessplikter faktiskt kräver.
Hindrar sekretess dig från att använda AI?
Om din data juridiskt inte får lämna byggnaden har du ändå alternativ — och de är mer praktiska än de flesta antar. Låt oss titta på om en on-premise-uppsättning är rimlig för dina förpliktelser, utan någon förpliktelse att bygga något.
Utforska on-premise AIVanliga frågor
Betyder on-premise AI att min data aldrig lämnar byggnaden?
Är en lokalt körd modell lika bra som de stora molnmodellerna?
Är inte on-premise AI väldigt dyrt?
Hur lång tid tar det att sätta upp ett sådant projekt?
Vem underhåller systemet när det väl körs?
Have a nice day är en mjukvarustudio som hjälper små och medelstora företag att bli digitala — automatisering, AI och skräddarsydd mjukvara som fungerar i vardagen, inte bara på slides.