IA on-premise pour un cabinet soumis à la confidentialité : une étude de cas
Un cabinet de conseil en sécurité voulait la productivité de l'IA moderne sans qu'un seul document ne quitte jamais ses murs. Voici comment nous avons bâti un assistant privé fonctionnant entièrement sur son propre matériel, et ce que cela a réellement demandé.
 Have a nice day15 min de lecture
Certaines entreprises ne peuvent pas confier leurs données au cloud d'un tiers, non par paranoïa, mais parce que la confidentialité est le produit qu'elles vendent réellement. Voici l'histoire d'un cabinet de ce genre, et comment nous lui avons donné la vitesse d'un assistant IA moderne sans qu'un seul dossier client ne quitte jamais ses quatre murs. Sans vernis marketing. Juste ce que nous avons essayé, ce qui a cassé et ce qui a fini par marcher.
Nous recevons un type précis de demande quelques fois par an. Elle commence souvent par une phrase comme : « Nous aimerions utiliser l'IA, mais nous n'avons légalement pas le droit d'envoyer nos données où que ce soit. » La personne au bout du fil a déjà vu des collègues coller du contenu sensible dans un chatbot public, a senti son estomac se nouer et a discrètement interdit toute la catégorie. Ces gens ne sont pas contre la technologie. Ils sont coincés entre une vraie occasion de productivité et un devoir de confidentialité non négociable.
Cette étude de cas porte sur un cabinet exactement comme cela. Pour respecter la confidentialité même qui a défini le projet, nous avons tout anonymisé : le nom, les personnes, les détails de ses clients. Les chiffres sont illustratifs et arrondis, pas des données auditées. Mais la forme du problème, et la manière dont nous l'avons résolu, sont exactement telles qu'elles se sont produites.
La situation : une productivité enfermée derrière un mur de confidentialité
Le client était un cabinet de conseil de taille moyenne dans un domaine où la discrétion n'est pas un plus agréable, mais la raison même pour laquelle les clients le mandatent. Imaginez un cabinet qui traite des dossiers sensibles d'ordre corporate, juridique ou proche de la sécurité, où une fuite ne serait pas seulement embarrassante : elle mettrait fin à l'activité. Une trentaine de personnes, une charge de dossiers sérieuse et une montagne de documents longs et denses que quelqu'un doit lire, résumer et recouper chaque semaine.
Son équipe avait vu le reste du monde accélérer grâce aux assistants IA et sentait l'écart se creuser. Un junior pouvait passer une demi-journée à extraire les points clés d'un rapport de 90 pages. Rédiger un premier résumé d'un dossier engloutissait des heures que personne ne facturait. Le travail était exactement ce genre de tâche dense et chargée de texte où l'IA moderne excelle réellement, et ils ne pouvaient rien y toucher.
Le verrou était simple et absolu. Leurs contrats clients et leur propre politique interne interdisaient d'envoyer du contenu client à tout service tiers. Ni anonymisé, ni chiffré en transit, ni « le prestataire promet de ne pas s'entraîner dessus ». Les données n'avaient pas le droit de quitter les locaux, point final. Tout outil d'IA cloud du marché était écarté par définition, aussi belle que soit sa politique de confidentialité sur le papier.
“Ils ne voulaient pas la promesse d'un prestataire que les données étaient en sûreté. Ils voulaient que les données ne soient jamais dans une position où une promesse serait nécessaire.”
Cette dernière distinction, c'est tout le projet en une phrase. Beaucoup d'offres d'« IA privée » sont en réalité le cloud d'un autre avec un contrat plus strict. Pour ce client, cela ne suffisait pas. La seule réponse acceptable était un système où les données sensibles ne voyageaient jamais physiquement, un système où l'on pourrait, en principe, débrancher le câble réseau et où l'assistant fonctionnerait encore.
Pourquoi les réponses cloud évidentes ne convenaient pas
Avant de construire quoi que ce soit, nous avons fait notre diligence sur les voies plus simples, car l'on-premise demande plus de travail et nous ne le recommanderons pas si une option plus simple convient vraiment. Pour ce client, chaque raccourci butait sur le même mur.
Les grands fournisseurs proposent tous des offres entreprise avec « nous ne nous entraînons pas sur vos données » et un hébergement régional. Rassurant, et pour bien des entreprises tout à fait suffisant. Mais cela signifie tout de même que les dossiers clients quittent les murs et reposent, même brièvement, sur une infrastructure que le cabinet ne contrôle pas. Pour un cabinet dont les contrats l'interdisent expressément, une promesse solide reste une promesse, et les promesses ne survivent pas à une question d'audit qui commence par « pouvez-vous garantir… ? ».
Nous avons aussi écarté une instance de cloud privé : un environnement dédié et isolé hébergé par un prestataire. Techniquement plus solide, et parfaitement adapté à certains cabinets. Mais cela plaçait tout de même les données sur du matériel loué, dans un bâtiment que le client ne possédait pas, et maintenait une dépendance à un prestataire extérieur pour une chose que le client voulait entièrement sous son propre toit. Il était prêt à échanger un peu de confort contre ce contrôle. Ce fut donc l'on-premise.
Ce que nous avons réellement construit
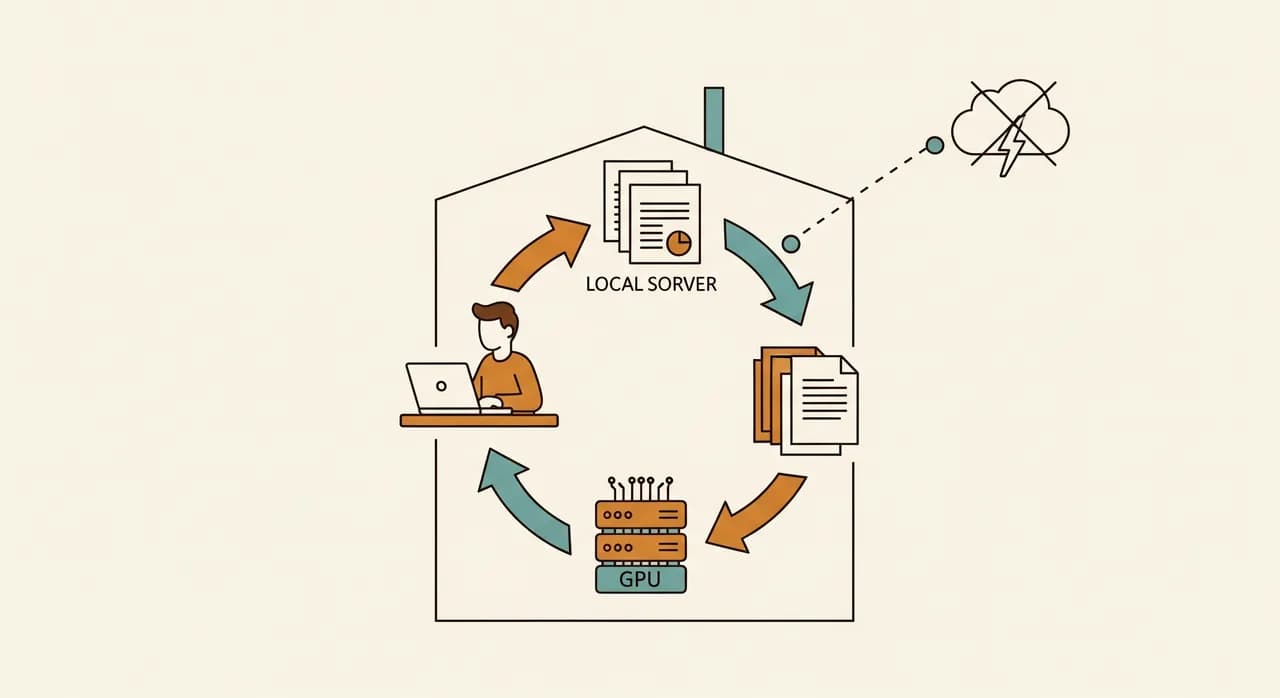
La solution, réduite à l'essentiel, était un assistant IA privé tournant sur un unique serveur performant à l'intérieur des bureaux du client. L'équipe y accède via une page web ordinaire dans son navigateur : cela ressemble aux outils de chat que tout le monde connaît déjà. Derrière cette fenêtre familière, rien ne quitte jamais le réseau local.
Nous avons délibérément gardé une architecture ennuyeuse. Ennuyeux rime avec fiable, et fiable est justement ce dont un système critique pour la confidentialité a besoin. Trois pièces mobiles méritent d'être nommées.
Un modèle à poids ouverts tournant en local
Plutôt que d'appeler un modèle hébergé, nous avons fait tourner un modèle de langage à poids ouverts performant directement sur le GPU du serveur. Les poids ouverts comptent ici : les fichiers du modèle résident sur le disque du client, tournent sur son matériel et répondent aux questions sans aucun aller-retour vers internet. Pour leur charge de travail (résumer, extraire, rédiger, répondre à des questions sur leurs propres documents) un modèle de taille moyenne bien choisi était plus que suffisant. Ils n'avaient pas besoin de la frontière absolue ; ils avaient besoin de compétence et de confidentialité.
Une couche de connaissance privée par-dessus leurs propres fichiers
La vraie valeur n'était pas un chatbot générique, mais un assistant capable de répondre à des questions sur leurs propres dossiers. Nous avons bâti une couche de recherche qui indexe leurs documents en local, si bien que lorsqu'on demande « qu'avons-nous conclu sur X dans l'affaire Müller », le système trouve les passages pertinents et répond à partir d'eux. Cet index, comme tout le reste, réside entièrement sur la machine locale. Aucun document, ni aucun fragment de document, n'est jamais téléversé où que ce soit.
Un contrôle d'accès aligné sur leurs règles existantes
Un cabinet de ce genre a déjà des règles strictes sur qui peut voir quels fichiers. L'assistant devait les respecter, non les contourner. L'accès reflétait donc leurs autorisations existantes : vous ne pouvez interroger l'IA que sur du contenu que vous avez déjà le droit d'ouvrir. Cela semble évident, mais c'est la partie qui transforme une démo astucieuse en quelque chose qu'un responsable conformité validera réellement.
Comment nous l'avons déployé sans perturber le travail
Un cabinet qui place la confidentialité au premier plan est, cela se comprend, prudent face aux nouveaux systèmes. Nous n'allions pas gagner sa confiance en actionnant un interrupteur et en criant victoire. Nous avons donc mené le projet comme une série de petites étapes réversibles, chacune prouvable avant d'entamer la suivante.
- 1Cadrer d'abord une tâche pénibleNous n'avons pas cherché à « ajouter de l'IA au cabinet ». Nous avons choisi une seule tâche à fort volume (résumer les longs documents entrants) et construit pour cela. Une cible claire, facile à juger comme succès ou échec.
- 2Construire sur une machine de test avec des données fictivesTout a d'abord été mis en place sur une machine isolée avec des documents inventés, si bien qu'aucune donnée client réelle n'a été impliquée avant que le système soit éprouvé et le modèle de sécurité revu.
- 3Mener un pilote fermé avec quelques utilisateurs avancésUne poignée de collaborateurs expérimentés l'a utilisé sur du travail réel pendant plusieurs semaines, en parallèle de leur processus habituel. Ils ont trouvé les aspérités (formulations étranges, quelques documents mal traités par l'index) et nous les avons corrigées.
- 4Le confronter à leur propre politiqueAvant tout déploiement plus large, leur responsable conformité a audité précisément où résidaient et se déplaçaient les données. Comme la réponse était « nulle part sauf ici », cette revue fut courte, ce qui était tout l'objectif de la conception.
- 5L'ouvrir à l'équipe avec un guide d'une pageCe n'est qu'une fois la confiance acquise que nous l'avons déployé à l'échelle du cabinet, avec une note en langage clair sur ce en quoi il est bon, ce en quoi il ne l'est pas, et le rappel qu'il n'invente jamais : il cite.
Le résultat : des heures récupérées, et rien n'a quitté les murs
En quelques mois après le déploiement complet, l'assistant était discrètement devenu partie intégrante de la routine quotidienne. Le résultat phare fut celui qui leur tenait le plus à cœur : pas un seul octet de données client n'a jamais quitté leurs locaux, et ils pouvaient le prouver à quiconque le demandait. Le système tourne sur leur serveur, dans leurs bureaux, sous leur contrôle. Cela seul justifiait le projet à leurs yeux.
Le volet productivité fut le bonus qui l'a rendu rentable. Le premier résumé d'un long document (auparavant une tâche de plusieurs heures pour un junior) est tombé à quelques minutes de relecture et d'édition. Les collaborateurs ont cessé de relire des dossiers entiers pour répondre à une seule question factuelle ; ils interrogeaient l'assistant, obtenaient un passage cité et le vérifiaient en quelques secondes. Sur l'ensemble de l'équipe, le temps libéré représentait une part significative de chaque semaine, réorientée du travail laborieux sur les documents vers l'analyse à plus forte valeur que les clients paient réellement.
Tout aussi révélateur fut un changement plus discret. Des personnes qui étaient restées discrètement inquiètes face à l'IA (craignant qu'elle ne soit une fuite en puissance) se sont mises à l'utiliser sereinement, précisément parce qu'elles comprenaient pourquoi elle était sûre. La confiance n'est pas venue de nos paroles rassurantes. Elle est venue d'une architecture qu'elles pouvaient expliquer à un client en une phrase : cela ne quitte jamais les murs.
| Aspect | Avant | Après |
|---|---|---|
| Résumer un long document | Une demi-journée, à la main | Quelques minutes pour relire un brouillon |
| Répondre à une question sur un dossier | Relire le dossier entier | Demander, obtenir un passage cité |
| Où vont les données client | Restent, mais IA interdite | Restent, et IA utilisable |
| Revue de conformité de l'outil | Échouerait dès le premier jour | Courte : rien ne sort |
| Confiance de l'équipe envers l'IA | Anxieuse, largement évitée | Sereine, comprise |
“La victoire n'était pas que l'IA soit brillante. C'était que, pour la première fois, la réponse de conformité et la réponse de productivité étaient la même réponse.”
Ce que cela a coûté, honnêtement
L'IA on-premise n'est pas l'option bon marché, et nous vous rendrions un mauvais service en prétendant le contraire. Il y a un vrai serveur doté d'un vrai GPU à acheter, un projet de mise en place à financer et une maintenance continue à budgéter : correctifs, mises à jour de modèle, un réglage occasionnel. Pour un cabinet dont la confidentialité est contractuelle, ce coût est facile à justifier. Pour un cabinet à qui l'idée de la confidentialité plaît simplement, il l'est souvent moins, et nous le dirons.
Le compromis honnête ressemble à ceci : un coût initial plus élevé et un peu plus de responsabilité en échange d'un contrôle total et de l'absence de frais cloud au message qui augmentent avec l'usage. Pour une équipe à forte utilisation traitant du contenu sensible, l'économie s'améliore même avec le temps : vous avez acheté la capacité au lieu de la louer à la requête. Pour un usage léger ou occasionnel, un outil cloud serait presque à coup sûr moins cher. Savoir de quel côté de cette ligne vous vous situez, c'est l'essentiel de la décision.
- Un serveur performant doté d'un GPU adapté : un achat en capital unique, pas un abonnement.
- Un projet de mise en place : installer et régler le modèle, construire l'index documentaire, câbler le contrôle d'accès.
- Une maintenance continue : correctifs de sécurité, mises à jour de modèle, réglages occasionnels selon l'évolution des besoins.
- Une responsabilité interne : une personne désignée qui garde un œil dessus, exactement comme pour tout système essentiel.
- Aucune facture cloud à la requête : un usage qui coûterait cher dans le cloud est pour ainsi dire gratuit une fois le matériel amorti.
Est-ce adapté à votre entreprise ?
Ce n'était pas un cas isolé. Le même schéma convient à tout cabinet où la contrainte est la sensibilité des données plutôt que le budget : cabinets juridiques, prestataires médicaux et proches de la santé, travail proche de la sécurité et de la défense, conseillers financiers, équipes de R&D assises sur des secrets industriels. Si vous vous êtes surpris à vouloir l'aide de l'IA tout en reculant à l'idée de l'endroit où iraient les données, vous êtes le public pour lequel cette approche a été bâtie.
De même, si vos données ne sont pas particulièrement sensibles et que vous ne feriez que payer un surcoût pour un ressenti, nous vous orienterons vers une bonne option cloud et vous éviterons la dépense. La bonne réponse dépend entièrement de vos obligations, pas de la technologie qui sonne le plus impressionnant. Le premier pas le plus utile n'est pas de choisir un modèle : c'est d'être honnête sur ce que vos devoirs de confidentialité exigent réellement.
La confidentialité vous empêche d'utiliser l'IA ?
Si vos données ne peuvent légalement pas quitter les murs, vous avez tout de même des options, et elles sont plus concrètes que la plupart ne l'imaginent. Voyons ensemble si un montage on-premise a du sens pour vos obligations, sans aucune obligation de construire quoi que ce soit.
Découvrir l'IA on-premiseQuestions fréquentes
L'IA on-premise signifie-t-elle que mes données ne quittent jamais les murs ?
Un modèle exécuté en local vaut-il les grands modèles du cloud ?
L'IA on-premise n'est-elle pas très coûteuse ?
Combien de temps faut-il pour mettre en place un tel projet ?
Qui maintient le système une fois en service ?
Have a nice day est un studio logiciel qui aide les petites et moyennes entreprises à se digitaliser — automatisation, IA et logiciels sur mesure qui fonctionnent au quotidien, pas seulement sur des diapositives.