IA on-premise para uma firma vinculada à confidencialidade: um caso real
Uma consultora de segurança queria a produtividade da IA moderna sem que um único documento saísse alguma vez do edifício. Eis como construímos um assistente privado que corre inteiramente no hardware deles, e o que isso exigiu de facto.
 Have a nice day14 min de leitura
Algumas empresas não podem colocar os seus dados na nuvem de outra pessoa, não por paranoia, mas porque a confidencialidade é o produto que realmente vendem. Esta é a história de uma firma assim, e de como lhe demos a velocidade de um assistente de IA moderno sem que um único ficheiro de cliente saísse alguma vez das suas quatro paredes. Sem verniz de marketing. Apenas o que tentámos, o que se partiu e o que finalmente funcionou.
Recebemos um tipo específico de pedido algumas vezes por ano. Costuma começar com uma frase como: «Adorávamos usar IA, mas legalmente não podemos enviar os nossos dados para lado nenhum.» A pessoa do outro lado já viu colegas colarem material sensível num chatbot público, sentiu um aperto no estômago e proibiu discretamente toda a categoria. Não são contra a tecnologia. Estão presas entre uma oportunidade real de produtividade e um dever de confidencialidade inegociável.
Este caso trata de uma firma exatamente assim. Para respeitar a própria confidencialidade que definiu o projeto, anonimizámos tudo: o nome, as pessoas, os detalhes dos seus clientes. Os números são ilustrativos e arredondados, não valores auditados. Mas a forma do problema, e o modo como o resolvemos, são exatamente como aconteceram.
A situação: produtividade fechada atrás de um muro de confidencialidade
O cliente era uma consultora de média dimensão numa área em que a discrição não é um extra agradável, mas a própria razão pela qual os clientes a contratam. Pense num escritório que lida com trabalho sensível de natureza empresarial, jurídica ou próxima da segurança, onde uma fuga não seria apenas embaraçosa: encerraria o negócio. Cerca de trinta pessoas, uma carga de processos considerável e uma montanha de documentos longos e densos que alguém tem de ler, resumir e cruzar todas as semanas.
A sua equipa tinha visto o resto do mundo acelerar com assistentes de IA e sentia a distância a aumentar. Um júnior podia passar meio dia a extrair os pontos-chave de um relatório de 90 páginas. Redigir um primeiro rascunho de resumo de um processo devorava horas que ninguém faturava. O trabalho era precisamente esse tipo de tarefa densa e carregada de texto em que a IA moderna é genuinamente boa, e não podiam tocar em nada disso.
O bloqueio era simples e absoluto. Os seus acordos com clientes e a sua própria política interna proibiam enviar material de cliente para qualquer serviço externo. Nem anonimizado, nem cifrado em trânsito, nem «o fornecedor promete não treinar com isso». Os dados não podiam sair das instalações, ponto final. Toda a ferramenta de IA na nuvem do mercado ficava excluída por definição, por melhor que parecesse a sua política de privacidade no papel.
“Não queriam a promessa de um fornecedor de que os dados estavam seguros. Queriam que os dados nunca estivessem numa posição em que fosse precisa uma promessa.”
Essa última distinção é o projeto inteiro numa frase. Muitas ofertas de «IA privada» são, na verdade, a nuvem de outra pessoa com um contrato mais rígido. Para este cliente, isso não bastava. A única resposta aceitável era um sistema em que os dados sensíveis nunca viajassem fisicamente, um em que, em princípio, se pudesse desligar o cabo de rede e o assistente continuasse a funcionar.
Porque é que as respostas óbvias da nuvem não serviam
Antes de construir o que quer que fosse, fizemos a nossa diligência sobre os caminhos mais fáceis, porque o on-premise dá mais trabalho e não o recomendamos se uma opção mais simples servir de facto. Para este cliente, cada atalho esbarrava no mesmo muro.
Os grandes fornecedores oferecem todos planos empresariais com «não treinamos com os seus dados» e alojamento regional. Tranquilizador, e para muitas empresas totalmente suficiente. Mas continua a significar que os ficheiros de cliente saem do edifício e ficam, ainda que brevemente, numa infraestrutura que a firma não controla. Para um escritório cujos contratos o proíbem expressamente, uma promessa sólida continua a ser uma promessa, e as promessas não sobrevivem a uma pergunta de auditoria que começa com «conseguem garantir…?».
Também excluímos uma instância de nuvem privada: um ambiente dedicado e isolado alojado por um fornecedor. Tecnicamente mais robusto, e perfeitamente adequado para algumas firmas. Mas continuava a colocar os dados em hardware alugado, num edifício que o cliente não possuía, e mantinha uma dependência de um fornecedor externo para algo que o cliente queria inteiramente sob o seu próprio teto. Estava disposto a trocar alguma comodidade por esse controlo. Por isso, foi on-premise.
O que realmente construímos
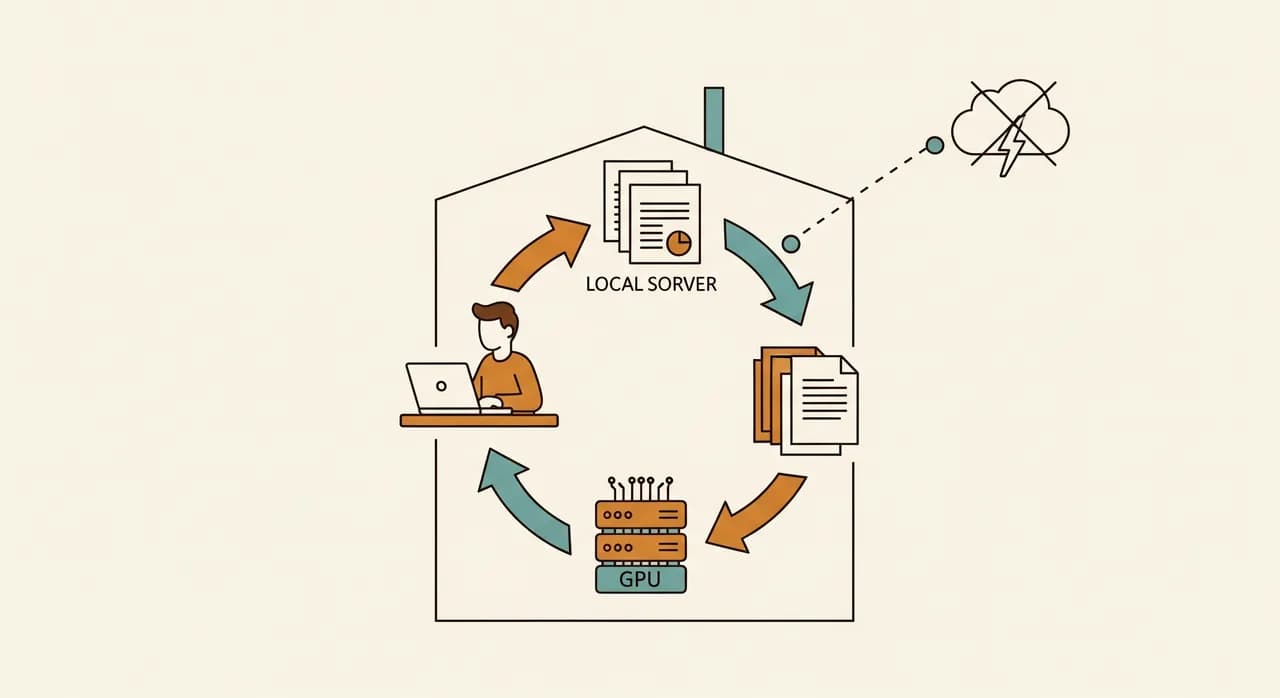
A solução, reduzida ao essencial, era um assistente de IA privado a correr num único servidor capaz dentro do próprio escritório do cliente. A equipa acede-lhe através de uma página web comum no navegador: tem o aspeto e a sensação das ferramentas de conversação que todos já conhecem. Por trás dessa janela familiar, nada sai alguma vez da rede local.
Mantivemos a arquitetura deliberadamente aborrecida. Aborrecido é fiável, e fiável é precisamente o que um sistema crítico para a privacidade precisa. Havia três peças móveis que vale a pena nomear.
Um modelo de pesos abertos a correr localmente
Em vez de chamar um modelo alojado, corremos um capaz modelo de linguagem de pesos abertos diretamente na GPU do servidor. Os pesos abertos importam aqui: os ficheiros do modelo residem no disco do cliente, correm no hardware do cliente e respondem a perguntas sem qualquer ida e volta à internet. Para a sua carga de trabalho (resumir, extrair, redigir, responder a perguntas sobre os próprios documentos) um modelo de dimensão média bem escolhido era mais do que suficiente. Não precisavam da fronteira absoluta; precisavam de competência e privacidade.
Uma camada de conhecimento privada sobre os seus próprios ficheiros
O verdadeiro valor não era um chatbot genérico, mas um assistente capaz de responder a perguntas sobre os seus próprios processos. Construímos uma camada de recuperação que indexa os seus documentos localmente, de modo que, quando alguém pergunta «o que concluímos sobre X no processo Müller», o sistema encontra as passagens relevantes e responde a partir delas. Esse índice, como tudo o resto, reside inteiramente na máquina local. Nenhum documento, nem um único fragmento dele, é alguma vez carregado para parte nenhuma.
Controlo de acesso alinhado com as suas regras existentes
Uma firma assim já tem regras rígidas sobre quem pode ver que ficheiros. O assistente tinha de as respeitar, não de as contornar. Por isso, o acesso espelhava as suas permissões existentes: só pode perguntar à IA sobre material que já tem autorização para abrir. Isto parece óbvio, mas é a parte que transforma uma demonstração engenhosa em algo que um responsável de conformidade vai realmente aprovar.
Como o implementámos sem perturbar o trabalho
Uma firma que coloca a confidencialidade em primeiro lugar é, compreensivelmente, cautelosa com sistemas novos. Não íamos ganhar confiança carregando num interruptor e proclamando vitória. Por isso, conduzimos o projeto como uma série de passos pequenos e reversíveis, cada um demonstrável antes de começar o seguinte.
- 1Delimitar primeiro uma tarefa penosaNão tentámos «adicionar IA à firma». Escolhemos um único trabalho de grande volume (resumir os longos documentos recebidos) e construímos para isso. Um alvo claro, fácil de julgar como sucesso ou fracasso.
- 2Construir numa máquina de teste com dados fictíciosTudo foi primeiro montado numa máquina isolada usando documentos inventados, de modo que nenhum dado real de cliente esteve envolvido até o sistema estar provado e o modelo de segurança revisto.
- 3Correr um piloto fechado com alguns utilizadores avançadosUm punhado de colaboradores seniores usou-o em trabalho real durante várias semanas, a par do seu processo habitual. Encontraram as arestas (formulações estranhas, alguns documentos que o índice tratava mal) e corrigimo-las.
- 4Confrontá-lo com a sua própria políticaAntes de qualquer implementação mais alargada, o seu responsável de conformidade auditou exatamente onde os dados residiam e se moviam. Como a resposta era «em lado nenhum a não ser aqui», essa revisão foi curta, o que era todo o objetivo do desenho.
- 5Abri-lo à equipa com um guia de uma páginaSó depois de merecer confiança o implementámos em toda a firma, com uma nota em linguagem simples sobre no que é bom, no que não é, e o lembrete de que nunca inventa: cita.
O resultado: horas recuperadas, e nada saiu do edifício
Em poucos meses após a implementação completa, o assistente tinha-se tornado discretamente parte da rotina diária. O resultado principal foi aquele com que mais se importavam: nem um único byte de dados de cliente saiu alguma vez das suas instalações, e podiam prová-lo a quem perguntasse. O sistema corre no seu servidor, no seu escritório, sob o seu controlo. Só isso justificava o projeto para eles.
O lado da produtividade foi o extra que o tornou rentável. O primeiro rascunho de resumo de um documento longo (antes uma tarefa de várias horas para um júnior) baixou para minutos de revisão e edição. Os colaboradores deixaram de reler processos inteiros para responder a uma única pergunta factual; perguntavam ao assistente, obtinham uma passagem citada e verificavam-na em segundos. Em toda a equipa, o tempo libertado somava uma parte significativa de cada semana, redirecionada de labutar sobre documentos para a análise de maior valor pela qual os clientes de facto pagam.
Igualmente revelador foi uma mudança mais subtil. Pessoas que tinham estado discretamente nervosas com a IA (receando que fosse uma fuga à espera de acontecer) passaram a usá-la com à-vontade, precisamente porque compreendiam porquê era segura. A confiança não veio de as tranquilizarmos. Veio de uma arquitetura que podiam explicar a um cliente numa frase: nunca sai do edifício.
| Aspeto | Antes | Depois |
|---|---|---|
| Resumir um documento longo | Meio dia, à mão | Minutos para rever um rascunho |
| Responder a uma pergunta sobre um processo | Reler o processo inteiro | Perguntar, obter uma passagem citada |
| Para onde vão os dados de cliente | Ficam, mas IA vedada | Ficam, e IA utilizável |
| Revisão de conformidade da ferramenta | Falharia no primeiro dia | Curta: nada sai |
| Confiança da equipa em usar IA | Ansiosa, quase sempre evitada | À-vontade, compreendida |
“A vitória não foi a IA ser inteligente. Foi que, pela primeira vez, a resposta da conformidade e a resposta da produtividade eram a mesma resposta.”
Quanto custou, com honestidade
A IA on-premise não é a opção barata, e prestar-lhe-íamos um mau serviço se fingíssemos o contrário. Há um servidor real com uma GPU real para comprar, um projeto de montagem para financiar e uma manutenção contínua para orçamentar: correções, atualizações do modelo, o ocasional acerto. Para uma firma cuja confidencialidade é contratual, esse custo é fácil de justificar. Para uma firma que apenas gosta da ideia de privacidade, muitas vezes não é, e nós dizemo-lo.
O compromisso honesto é este: um custo inicial mais elevado e um pouco mais de responsabilidade em troca de controlo total e da ausência de taxas de nuvem por mensagem que crescem com o uso. Para uma equipa de uso intenso que lida com material sensível, a economia até melhora com o tempo: comprou a capacidade em vez de a alugar por consulta. Para uso ligeiro ou ocasional, uma ferramenta na nuvem seria quase de certeza mais barata. Saber de que lado dessa linha está é a maior parte da decisão.
- Um servidor capaz com uma GPU adequada: uma compra de capital única, não uma subscrição.
- Um projeto de montagem: instalar e afinar o modelo, construir o índice de documentos, ligar o controlo de acesso.
- Manutenção contínua: correções de segurança, atualizações do modelo, reafinações ocasionais à medida que as necessidades mudam.
- Responsabilidade interna: uma pessoa designada que fica de olho nisso, tal como faria com qualquer sistema essencial.
- Sem fatura de nuvem por consulta: um uso que ficaria caro na nuvem é praticamente gratuito assim que o hardware está pago.
Isto serviria à sua empresa?
Não foi um caso único. O mesmo padrão serve a qualquer firma em que a restrição seja a sensibilidade dos dados e não o orçamento: escritórios jurídicos, prestadores médicos e da área da saúde, trabalho próximo da segurança e da defesa, consultores financeiros, equipas de I&D sentadas sobre segredos comerciais. Se já se viu a querer a ajuda da IA mas a recuar perante a ideia de para onde iriam os dados, é o público para quem esta abordagem foi construída.
Da mesma forma, se os seus dados não forem particularmente sensíveis e apenas pagasse um sobrecusto por uma sensação, indicar-lhe-emos uma boa opção na nuvem e poupamos-lhe a despesa. A resposta certa depende inteiramente das suas obrigações, não de qual tecnologia soa mais impressionante. O primeiro passo mais útil não é escolher um modelo: é ser honesto sobre o que os seus deveres de confidencialidade realmente exigem.
A confidencialidade impede-o de usar IA?
Se os seus dados legalmente não podem sair do edifício, ainda tem opções, e são mais práticas do que a maioria supõe. Vejamos se uma montagem on-premise faz sentido para as suas obrigações, sem qualquer compromisso de construir seja o que for.
Explorar a IA on-premisePerguntas frequentes
A IA on-premise significa que os meus dados nunca saem do edifício?
Um modelo executado localmente é tão bom como os grandes da nuvem?
A IA on-premise não é muito cara?
Quanto tempo leva a montar um projeto destes?
Quem mantém o sistema depois de estar a funcionar?
A Have a nice day é um estúdio de software que ajuda pequenas e médias empresas a digitalizarem-se — automação, IA e software à medida que funciona no dia a dia, não apenas nos slides.