Wie wir einen KI-Assistenten in eine SaaS-Plattform eingebaut haben — ohne sie kaputt zu machen
Ein kleines SaaS-Team hatte einen Support-Rückstau und eine Funktion, die seine Nutzer nicht fanden. Das ist die ehrliche Geschichte, wie wir einen KI-Assistenten in ihr Produkt gebracht haben — was funktionierte, was wir verworfen haben und welche Zahl sich am Ende endlich bewegte.
 Have a nice day12 Min. Lesezeit
Jedes SaaS-Team, mit dem wir sprechen, sagt irgendwann denselben Satz laut: „Wir sollten hier einen KI-Assistenten einbauen." Manchmal ist es Druck vom Beirat, manchmal der Launch eines Wettbewerbers, manchmal echte Überzeugung. Das Interessante ist nie die Idee — die hat fast jeder. Interessant ist die Lücke zwischen diesem Satz und einer Funktion, auf die sich echte Nutzer tatsächlich verlassen. Das ist die Geschichte eines Teams, das diese Lücke überwunden hat, und der unspektakulären Entscheidungen, die es dorthin gebracht haben.
Eine kurze Anmerkung vorweg: Wir haben den Kunden anonymisiert und die Zahlen gerundet. Es handelt sich um ein kleines, profitables B2B-SaaS-Unternehmen — unter zwanzig Personen —, das ein Workflow-Tool an Operations-Teams verkauft. Wir haben genug Details geändert, dass Sie es nicht erkennen werden, aber die Struktur des Projekts ist genau so passiert. Die Zahlen sind illustrativ, nicht geprüft; wir zeigen Ihnen lieber das Muster, als eine Grafik aufzuhübschen.
Wir schreiben das auf, weil das Projekt ein nahezu perfektes Beispiel dafür ist, wie solche Dinge tatsächlich laufen. Es lief nicht so, wie es das Kickoff-Deck versprochen hatte. Es lief besser — aber nur, weil wir bereit waren, die erste Version zu löschen.
Die Ausgangslage: zwei Probleme in einem Kostüm
Als der Gründer sich zum ersten Mal meldete, war die Anfrage einfach: „Wir wollen einen KI-Chatbot in der App." Genau da starten die meisten Projekte — und genau da laufen die meisten still aus dem Ruder. „KI-Chatbot" ist kein Ziel, sondern eine Form. Unsere erste Aufgabe war also herauszufinden, welches Problem der Chatbot eigentlich lösen sollte — und ob es überhaupt ein einziges Problem war.
War es nicht. Unter dieser einen Anfrage steckten zwei völlig unterschiedliche Schmerzpunkte. Der erste war die Support-Last: ein zweiköpfiges Customer-Success-Team ertrank in wiederkehrenden Tickets — „wie exportiere ich das", „wo ist die Einstellung dafür", „warum lief mein Report nicht". Rund 60 % der eingehenden Tickets waren Fragen, die irgendwo in ihrer Hilfe-Dokumentation bereits beantwortet waren. Der zweite Schmerzpunkt war leiser und teurer: die Aktivierung. Ihr Produkt hatte eine wirklich starke Funktion, drei Klicks tief vergraben, die kaum jemand von selbst entdeckte. Nutzer, die sie fanden, blieben jahrelang. Nutzer, die sie nicht fanden, kündigten in den ersten zwei Monaten.
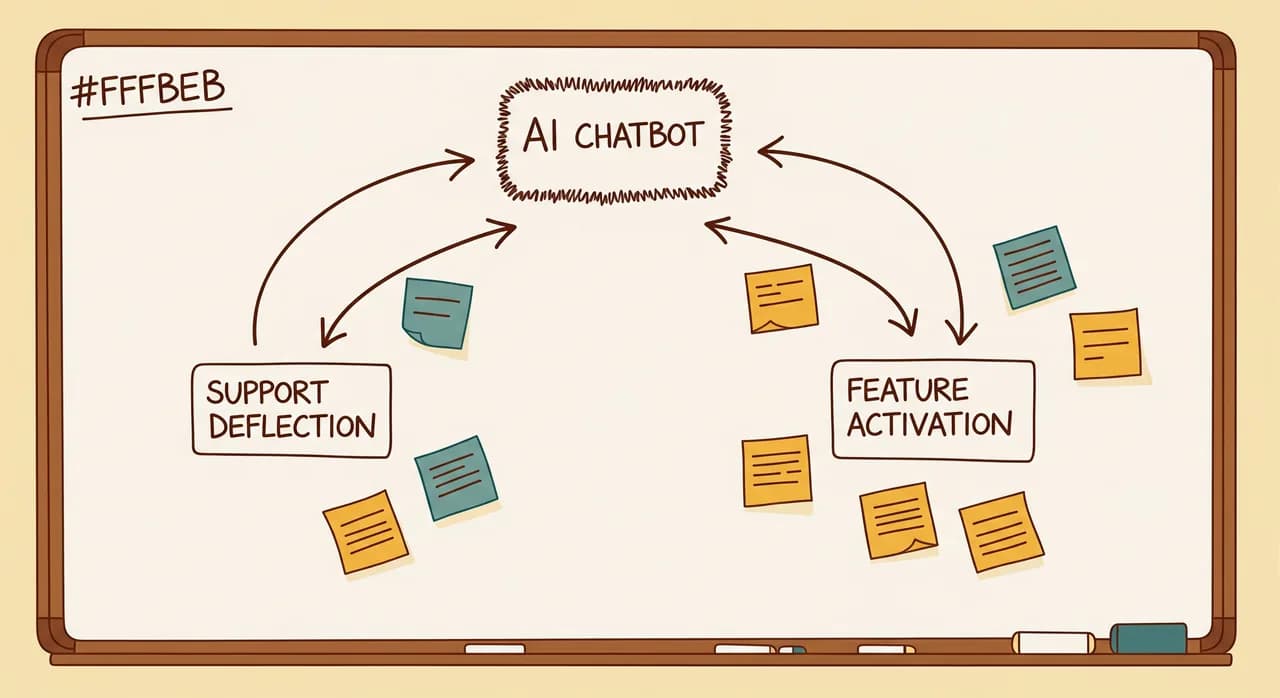
Gleiches Kostüm, zwei Probleme. Und sie zogen in unterschiedliche Richtungen. Ein Support-Bot will Fragen abfangen und sich aus dem Weg räumen. Ein Aktivierungs-Assistent will Gespräche beginnen und Menschen zu Dingen anstupsen, nach denen sie gar nicht gefragt haben. Hätten wir „einen KI-Chatbot" gebaut, ohne das zu trennen, hätten wir etwas gebaut, das beide Jobs schlecht macht.
“„KI-Chatbot" ist eine Form, kein Ziel. Die erste Projektwoche verging damit, herauszufinden, welches Problem wir eigentlich lösen sollten.”
Herunterskalieren auf etwas, das wir zu Ende bringen konnten
Angesichts zweier Probleme ist die Versuchung groß, einen großen Assistenten zu bauen, der beide vom ersten Tag an bedient. Wir haben dem Team davon abgeraten. Nicht, weil die Vision falsch war, sondern weil ein sechsmonatiger „Alles-Assistent" genau die Art Projekt ist, das zu spät liefert, flach aufschlägt und alle für die nächsten zwei Jahre nervös gegenüber KI macht.
Also entschieden wir uns für eines. Wir wählten zuerst die Support-Deflection, aus drei langweiligen, aber entscheidenden Gründen. Sie hatte ein klares, messbares Ziel — das Ticketvolumen. Sie nutzte bereits vorhandene Inhalte — die Hilfe-Dokumentation und alte Tickets. Und wenn sie unterperformte, war der Schaden klein: ein Nutzer, der keine gute Antwort bekam, tat einfach, was er ohnehin tat, und öffnete ein Ticket. Geringes Risiko, schnelles Feedback, ehrliche Kennzahl. Das ist jedes Mal eine gute erste KI-Funktion.
Der Aktivierungs-Assistent verschwand nicht — wir parkten ihn auf dem Papier, mit einer klaren Notiz: Phase zwei, sobald die Retrieval-Schicht bewiesen ist. Diese eine Entscheidung hat das Projekt wahrscheinlich gerettet. Sie gab dem Team eine Ziellinie, die es in Wochen statt in Quartalen tatsächlich erreichen konnte.
Der erste Prototyp, den wir gebaut — und gelöscht — haben
Hier ist der Teil, den die meisten Fallstudien weglassen. Unser erster funktionierender Prototyp war, freundlich gesagt, nicht gut. Wir taten das Naheliegende: verdrahteten die Hilfeartikel des Produkts mit einem großen Sprachmodell, fügten ein Chat-Feld hinzu und ließen Nutzer Fragen stellen. In der Demo sah es magisch aus. Im echten Test fiel es auf eine sehr spezifische, sehr lehrreiche Weise auseinander.
Das Modell lag selbstbewusst falsch. Auf die Frage nach einer sechs Monate zuvor umbenannten Einstellung erfand es fröhlich den alten Menüpfad. Auf die Frage nach einer Funktion in einem höheren Tarif erklärte es, wie man sie nutzt — einem Kunden, der keinen Zugriff darauf hatte. Jede Antwort klang autoritativ, was die falschen schlimmer machte als gar keine Antwort. Ein Support-Bot, der höflich lügt, reduziert keine Tickets; er erzeugt wütendere.
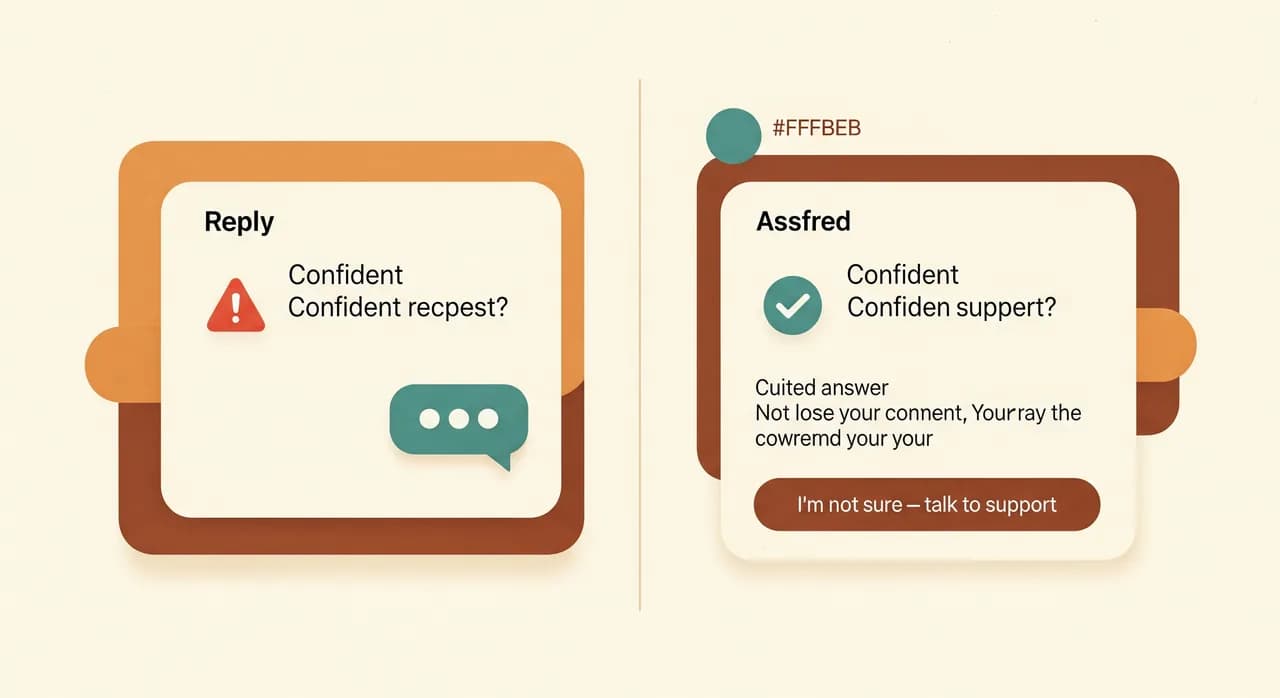
Wir hätten das mit Prompt-Anpassungen übertünchen können. Stattdessen taten wir etwas, das sich wie ein Rückschritt anfühlte und sich als das ganze Spiel herausstellte: Wir warfen den ersten Prototyp weg und bauten ihn um eine strikte Regel herum neu — der Assistent darf nur aus Quellen antworten, die er zitieren kann, und muss sonst „Ich weiß es nicht" sagen.
Was wir tatsächlich gebaut haben
Die Version, die live ging, war bewusst bescheiden in dem, was sie versuchte, und streng in ihrem Verhalten. Unter der Haube war sie ein retrieval-gestützter Assistent: Wenn ein Nutzer etwas fragte, durchsuchte das System zunächst eine kuratierte, aktuelle Wissensdatenbank und bat das Modell dann, nur aus dem Gefundenen zu antworten, mit einem Link zurück zur Quelle. Keine Quelle, keine selbstbewusste Antwort — nur eine saubere Übergabe an einen Menschen.
Drei Design-Entscheidungen erledigten die meiste Arbeit, und keine davon ist aufregend. Genau das ist der Punkt — die langweiligen Entscheidungen sind meist die, die darüber entscheiden, ob einer KI-Funktion vertraut wird oder ob sie still abgeschaltet wird.
Erdung statt Cleverness
Jede Antwort war an ein echtes, aktuelles Dokument gebunden. Wir verbrachten mehr Zeit damit, die Wissensdatenbank zu bereinigen und zu strukturieren, als das Modell zu tunen. Unspektakulär und mit Abstand die wirkungsvollste Arbeit im Projekt. Ein mittelmäßiges Modell auf exzellenten, gut gepflegten Inhalten schlägt ein brillantes Modell auf einem veralteten Durcheinander.
Eine elegante Übergabe
Wenn der Assistent nicht sicher war, riet er nicht. Er sagte es und bot einen Ein-Klick-Weg zu einem Menschen — und nahm den Gesprächskontext mit, sodass der Nutzer sich nie wiederholen musste. Kontraintuitiv ließ das die Menschen dem Bot mehr vertrauen: ein Assistent, der seine Grenzen zugibt, wirkt ehrlich, und sie stützten sich gerade deshalb bei den einfachen 60 % auf ihn, weil er bei den schwierigen 40 % zur Seite trat.
Weiß, wer fragt
Weil er im Produkt lebte, kannte der Assistent den Tarif, die Rolle und den Ort des Nutzers in der App. So erklärte er nie eine Funktion, auf die man keinen Zugriff hatte, und konnte sagen: „Der Button, den Sie suchen, ist auf dem Bildschirm, auf dem Sie gerade sind." Diese Produkt-Kenntnis ist der eigentliche Vorteil eines In-App-Assistenten gegenüber einem generischen Chatbot, den man an eine Marketing-Website schraubt.
- 1Wissensdatenbank bereinigt und strukturiertJedes Hilfe-Dokument geprüft, die veralteten entfernt und den Rest nach Tarif und Funktion getaggt. Das war Woche eins — und die wichtigste Woche.
- 2Retrieval-Schicht gebautErst suchen, dann antworten. Das Modell sah nur geprüfte, aktuelle Inhalte — und wurde angewiesen, alles abzulehnen, was es nicht in einer Quelle verankern konnte.
- 3Produktkontext verdrahtetDen Assistenten mit Tarif, Rolle und aktuellem Bildschirm des Nutzers verbunden, damit Antworten zugeschnitten waren und nie auf unzugängliche Funktionen verwiesen.
- 4Die ehrliche Rückfalloption gestaltetDen „Ich bin mir nicht sicher — hier ist ein Mensch"-Weg als erstklassige Funktion gebaut, mit vollem Gesprächskontext für das Support-Team.
- 5An 10 % der Nutzer hinter einem Flag ausgeliefertStill an einen Teil der Konten ausgerollt, zwei Wochen echte Gespräche beobachtet, Kaputtes repariert und dann den Rollout ausgeweitet.
Die Ergebnisse — und das eine, das uns überraschte
Nachdem der Assistent etwa drei Monate für alle live war, war das Bild klar. Wir geben Ihnen gerundete, illustrative Zahlen — die Richtung zählt mehr als die Nachkommastellen.
| Kennzahl | Vorher | Nachher | Veränderung |
|---|---|---|---|
| Wiederkehrende Support-Tickets | ~100/Woche | ~45/Woche | Etwa die Hälfte abgefangen |
| Mittlere Erstreaktionszeit | ~5 Stunden | Fast sofort bei häufigen Fragen | Stunden zu Sekunden |
| Fokus des Support-Teams | Meist wiederkehrende Q&A | Meist komplexe, wertvolle Fälle | Besserer Einsatz zweier Personen |
| „Kann nicht antworten"-Rate des Assistenten | — | ~20 % (an Menschen übergeben) | Ehrlich, nicht versteckt |
Die Support-Zahl war die, die wir versprochen hatten, und sie lieferte: etwas mehr als die Hälfte der wiederkehrenden Tickets kam schlicht nicht mehr an, und das zweiköpfige Team bekam seine Woche zurück, um die Fälle zu bearbeiten, die wirklich einen Menschen brauchten. Gutes Ergebnis, genau wie definiert.
Aber das Ergebnis, das den Gründer wirklich überraschte, war eines, für das wir überhaupt nicht optimiert hatten. Weil der Assistent den ganzen Tag „Wie mache ich X"-Fragen beantwortete, verwies er die Nutzer immer wieder ganz natürlich auf jene vergrabene, bindende Funktion — die mit der Kundenbindung verknüpfte. Wir hatten den Aktivierungs-Assistenten noch gar nicht gebaut. Der Support-Bot erledigte still einen Teil von dessen Job als Nebeneffekt, einfach indem er hilfreich und produktbewusst war. Neue Nutzer fanden die Funktion Wochen früher als zuvor.
“Wir haben ein Support-Tool ausgeliefert. Es entpuppte sich als Onboarding-Tool im Gewand eines Support-Tools — genau deshalb bekam Phase zwei grünes Licht.”
Was wir dem nächsten Team sagen würden
Wenn Sie ein SaaS-Team sind, das auf denselben Satz „Wir sollten einen KI-Assistenten hinzufügen" starrt, lassen sich ein paar Dinge aus diesem Projekt weit darüber hinaus verallgemeinern.
- Trennen Sie die Probleme, bevor Sie bauen. „KI-Chatbot" verbirgt fast immer zwei oder drei unterschiedliche Jobs, die verschiedene Designs verlangen.
- Beginnen Sie mit dem Anwendungsfall, bei dem eine falsche Antwort am wenigsten kostet. Support-Deflection ist ein nahezu perfekter erster Schritt; der Rückfall ist der Status quo.
- Verplanen Sie den Großteil Ihrer Mühe für die Inhalte, nicht für das Modell. Erdung auf sauberen, aktuellen Daten macht einen Assistenten vertrauenswürdig.
- Machen Sie „Ich weiß es nicht" zu einer Funktion, nicht zu einem Versagen. Eine ehrliche Übergabe baut das Vertrauen auf, das Nutzer sich auf die guten Teile verlassen lässt.
- Liefern Sie zuerst hinter einem Flag an einen kleinen Teil aus. Echte Gespräche lehren Sie Dinge, die keine Demo je vermittelt.
Denken Sie über eine KI-Funktion in Ihrem Produkt nach?
Der schwierigste Teil ist selten das Modell — es ist, die Sache so zu scopen, dass sie ausgeliefert wird und Vertrauen gewinnt. Wir helfen SaaS- und Software-Teams herauszufinden, was wirklich lohnt, und bauen es dann. Ein erstes Gespräch kostet Sie nichts außer Zeit.
So bauen wir KI-FunktionenHäufige Fragen
Wie lange hat dieses Projekt gedauert?
Brauchen wir riesige Datenmengen, um einen KI-Assistenten hinzuzufügen?
Gibt ein KI-Assistent Kunden nicht falsche Antworten?
Sollten wir das selbst bauen oder Hilfe holen?
Was ist eine sinnvolle erste KI-Funktion für ein SaaS-Produkt?
Have a nice day ist ein Software-Studio, das kleine und mittlere Unternehmen digitalisiert — Automatisierung, KI und maßgeschneiderte Software, die im Alltag funktioniert, nicht nur auf Folien.