プライバシー最優先の企業向けオンプレミスAI:導入事例
あるセキュリティコンサルティング会社は、社外に文書を一切出すことなく、最新AIの生産性を求めていました。自社ハードウェア上だけで完結するプライベートアシスタントをどう構築したか、そして実際に何が必要だったかをお伝えします。
 Have a nice day読了 約3分
自社のデータを他社のクラウドに置けない企業があります。神経質だからではなく、機密保持そのものが彼らの売り物だからです。これは、まさにそうした一社の物語であり、顧客ファイルを一枚たりとも社外に出すことなく、最新AIアシスタントのスピードを届けた記録です。誇張された宣伝文句は一切なし。試したこと、うまくいかなかったこと、そして最終的に機能したものだけをお伝えします。
私たちは年に数回、ある種の問い合わせを受け取ります。たいていは次のような一文で始まります。「AIを使いたいのですが、法律上データをどこにも送れないのです。」連絡してくる方は、同僚が公開チャットボットに機密資料を貼り付けるのを見て背筋が凍り、その分野全体をひそかに禁止した経験を持っています。彼らは技術嫌いではありません。現実の生産性向上のチャンスと、譲れない守秘義務の間で身動きが取れなくなっているのです。
この事例は、まさにそうした企業についての話です。プロジェクトを定義づけたその守秘義務を尊重するため、社名も人物も顧客の詳細も、すべて匿名化しています。数字は例示的なもので、概数に丸めてあり、監査済みの実数ではありません。しかし、問題の形と、それを解決した方法は、実際に起きたそのままです。
状況:守秘義務の壁に閉じ込められた生産性
この顧客は、慎重さが「あれば嬉しい」ではなく、顧客が依頼する理由そのものである分野の、中規模のアドバイザリー会社でした。企業法務やセキュリティに近い機密性の高い案件を扱う事務所を想像してください。情報漏えいは単なる恥ではなく、事業の終わりを意味します。約30名、深刻な案件量、そして誰かが毎週読み、要約し、相互参照しなければならない長大で緻密な文書の山があります。
彼らのチームは、世界の他の人々がAIアシスタントで加速していくのを目にし、その差が広がっていくのを感じていました。若手が90ページの報告書から要点を抜き出すのに半日を費やすこともありました。案件ファイルの一次要約の作成には、誰も請求できない何時間もが消えていきました。その仕事はまさに、最新AIが本当に得意とする、緻密で言語処理の重い作業でした。それなのに、彼らはその一切に手を出せなかったのです。
障壁は単純かつ絶対的でした。顧客との契約と自社の内部規定が、顧客資料を第三者サービスに送ることを禁じていました。匿名化しても、通信の暗号化を施しても、「学習には使わないとベンダーが約束している」でもだめ。データは社外に出ることを許されない、それだけです。市場に出回るあらゆるクラウドAIツールは、プライバシーポリシーが書面上どれほど立派に見えても、定義上、選択肢から外れていました。
“彼らが求めたのは、データが安全だというベンダーの約束ではありません。約束が必要になる状況に、データを一度も置かないことでした。”
この最後の区別こそ、プロジェクト全体を一文で言い表しています。多くの「プライベートAI」の提供物は、実のところより厳格な契約が付いた他社のクラウドにすぎません。この顧客にとって、それでは不十分でした。唯一受け入れられる答えは、機密データが物理的に一度も移動しないシステム。原理的にネットワークケーブルを抜いても、アシスタントが動き続ける仕組みだったのです。
なぜ当たり前のクラウドの答えが合わなかったか
何かを構築する前に、より簡単な道筋を十分に検討しました。オンプレミスは手間がかかるので、より単純な選択肢が本当に合うなら私たちはそれを勧めません。しかしこの顧客の場合、どの近道も同じ壁の前で崩れました。
大手プロバイダーはいずれも、「お客様のデータで学習しません」と地域内ホスティングを備えたエンタープライズ向けプランを提供しています。安心できますし、多くの企業にとっては十分です。しかしそれでも、顧客ファイルは社外に出て、たとえ一瞬でも、事務所が管理しないインフラ上に置かれます。それを契約で明確に禁じている事務所にとって、強力な約束もやはり約束にすぎません。「保証できますか…」で始まる監査の質問に、約束は耐えられないのです。
プライベートクラウドインスタンス、つまりプロバイダーがホストする専用の隔離環境も検討から外しました。技術的にはより強固で、一部の事務所には申し分なく合います。しかしそれでもデータは、顧客が所有しない建物の中の借り物のハードウェア上に置かれ、自社の屋根の下で完結させたかったものについて外部ベンダーへの依存が残ります。彼らはその管理権のために、多少の利便性を手放す覚悟がありました。だからオンプレミスに決まったのです。
実際に構築したもの
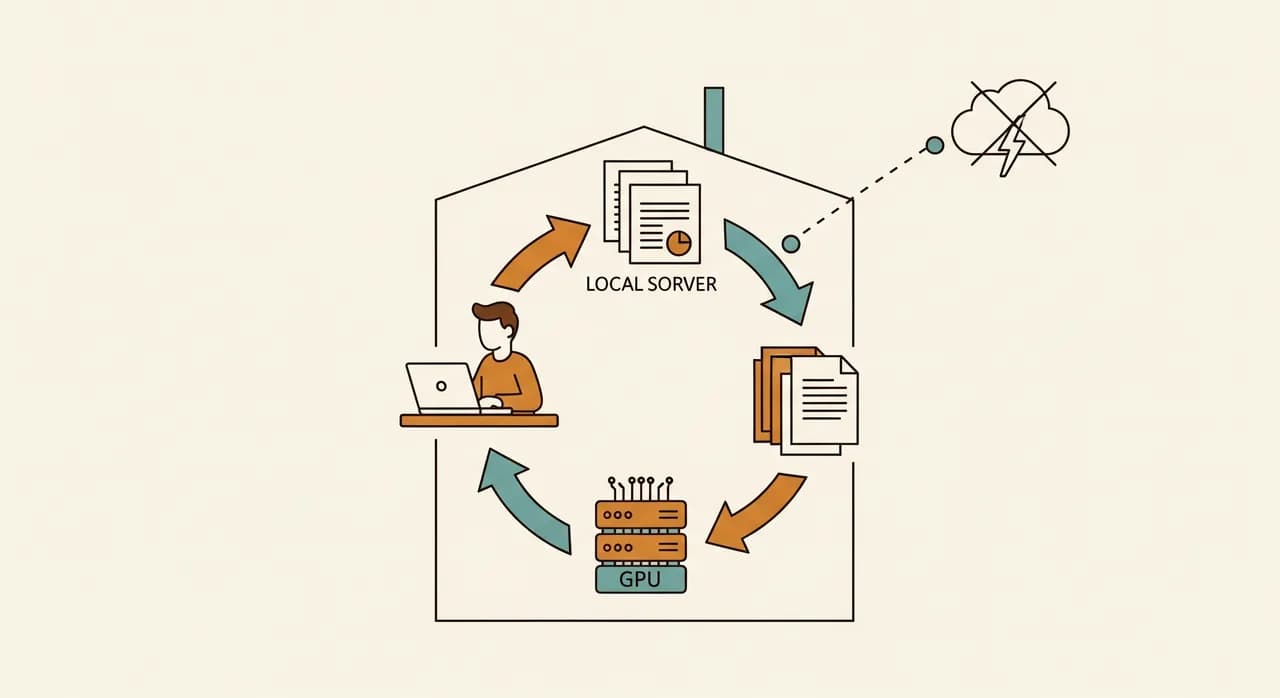
解決策を本質までそぎ落とすと、顧客自身のオフィス内にある一台の高性能サーバー上で動作するプライベートAIアシスタントでした。チームはブラウザ上のごく普通のウェブページからアクセスします。誰もがすでに知っているチャットツールのように見え、そう感じられます。その見慣れた画面の裏側では、何一つローカルネットワークの外に出ません。
私たちは意図的にアーキテクチャを退屈なものに保ちました。退屈は信頼できるということであり、プライバシーが重要なシステムに必要なのは信頼性です。名を挙げるに値する可動部分は三つありました。
ローカルで動くオープンウェイトモデル
ホスト型モデルを呼び出すのではなく、高性能なオープンウェイトの言語モデルをサーバーのGPU上で直接動かしました。ここでオープンウェイトであることが重要です。モデルファイルは顧客のディスク上に置かれ、顧客のハードウェアで動作し、インターネットへの往復なしに質問に答えます。彼らの業務、つまり要約、抽出、下書き作成、自社文書についての質問への回答には、適切に選んだ中規模モデルで十二分でした。最先端は必要なく、必要なのは有能でプライベートなものだったのです。
自社ファイルの上に築いたプライベートな知識層
本当の価値は汎用チャットボットではなく、自社の案件ファイルについて質問に答えられるアシスタントでした。私たちは彼らの文書をローカルでインデックス化する検索層を構築しました。だから誰かが「ミュラー案件でXについて我々はどう結論づけたか」と尋ねると、システムは関連する箇所を見つけ、そこから答えます。そのインデックスも、他のすべてと同様に、完全にローカルマシン上にあります。どの文書も、その断片一つも、どこにもアップロードされることはありません。
既存のルールに沿ったアクセス制御
このような事務所には、誰がどのファイルを見られるかについて、すでに厳格なルールがあります。アシスタントはそれを迂回するのではなく、尊重しなければなりませんでした。そこでアクセス権は既存の権限を反映させました。あなたがすでに開くことを許されている資料についてのみ、AIに尋ねられます。当たり前に聞こえますが、これこそが気の利いたデモを、コンプライアンス責任者が実際に承認できるものへと変える部分なのです。
業務を妨げずに展開した方法
プライバシー最優先の事務所が新しいシステムに慎重なのは当然です。スイッチを入れて勝利宣言をしても、信頼は得られません。そこで私たちはプロジェクトを、小さく可逆的なステップの連続として進めました。各ステップは次に進む前に証明できるものにしました。
- 1まず一つの厄介な作業に絞った「事務所にAIを入れる」ことを目指したのではありません。長い受信文書の要約という、量の多い一つの仕事を選び、それに向けて構築しました。明確な一つの標的は、成功か失敗かを判断しやすいのです。
- 2ダミーデータでテスト機上に構築したすべてはまず、架空の文書を使って隔離されたマシン上に立ち上げました。システムが実証され、セキュリティモデルが検証されるまで、本物の顧客データは一切関与させませんでした。
- 3少数のパワーユーザーで限定パイロットを実施した数名のベテランが、通常の手順と並行して、実際の業務で数週間これを使いました。彼らは荒削りな部分、つまり奇妙な言い回しや、インデックスがうまく扱えなかった数点の文書を見つけ出し、私たちが修正しました。
- 4自社の規定に照らして検証した本格展開の前に、彼らのコンプライアンス責任者が、データがどこに存在し、どこへ移動するかを厳密に監査しました。答えが「ここ以外どこにもない」だったため、その検証は短く済みました。それこそが設計上の狙いでした。
- 5一枚のガイドとともにチームへ開放した信頼を得て初めて、事務所全体に展開しました。得意なこと、不得意なこと、そして決して捏造せず必ず出典を示すという注意点を、平易な言葉でまとめた案内を添えて。
成果:取り戻した時間、そして社外に出なかったすべて
本格展開から数か月のうちに、アシスタントは静かに日々の習慣の一部になりました。目玉となった成果は、彼らが最も気にかけていたものでした。顧客データが一バイトたりとも社外に出なかったこと、そしてそれを尋ねてくる誰にでも証明できたことです。システムは彼らのサーバー上で、彼らのオフィスで、彼らの管理下で動きます。それだけで、彼らにとってプロジェクトは正当化されました。
生産性の側面は、投資を回収させたおまけでした。長い文書の一次要約は、以前は若手にとって数時間の仕事でしたが、確認と修正の数分にまで縮まりました。スタッフは一つの事実質問に答えるためにファイル全体を読み返すのをやめ、アシスタントに尋ね、出典付きの一節を得て、数秒で確認するようになりました。チーム全体で解放された時間は、毎週の相当な部分に積み上がり、文書を延々と処理することから、顧客が本当に対価を払う高付加価値の分析へと振り向けられました。
同じくらい示唆的だったのは、より穏やかな変化でした。AIにひそかに不安を抱いていた人々、漏えいが起きるのを待っているだけだと心配していた人々が、快適に使えるようになったのです。それはまさに、なぜ安全なのかを彼らが理解したからでした。信頼は私たちが安心させたことからは生まれませんでした。顧客に一文で説明できるアーキテクチャから生まれたのです。「社外には決して出ません」と。
| 観点 | 導入前 | 導入後 |
|---|---|---|
| 長い文書の要約 | 手作業で半日 | 下書きの確認に数分 |
| ファイルに関する質問への回答 | ファイル全体を読み返す | 尋ねて出典付きの一節を得る |
| 顧客データの行き先 | 社内に留まるがAIは使えない | 社内に留まりAIも使える |
| ツールのコンプライアンス検証 | 初日で不合格になる | 短い。何も出ていかないから |
| AI利用へのチームの自信 | 不安で、ほぼ避けていた | 安心して、理解して使う |
“勝因はAIが賢かったことではありません。初めて、コンプライアンスの答えと生産性の答えが同じ答えになったことです。”
正直に言う、かかったコスト
オンプレミスAIは安価な選択肢ではありません。そうでないふりをするのはお客様に対して不誠実でしょう。本物のGPUを積んだ本物のサーバーを買い、構築プロジェクトに資金を投じ、継続的な保守、つまりパッチ、モデル更新、時折のチューニングを予算化する必要があります。守秘義務が契約上のものである事務所にとって、そのコストは正当化しやすいものです。単にプライバシーという発想を気に入っているだけの事務所にとっては、しばしばそうではなく、私たちはそう申し上げます。
正直なトレードオフはこうです。総合的な管理権と、利用量に応じて膨らむメッセージごとのクラウド料金がないことと引き換えに、初期コストが高く、責任も少し増えます。機密資料を扱う利用量の多いチームにとって、採算は時とともにむしろ改善します。問い合わせごとに借りるのではなく、処理能力を買い切っているからです。軽い、あるいは時々の利用なら、クラウドツールのほうがほぼ確実に安上がりでしょう。自分がその線のどちら側にいるかを知ることが、決断の大部分です。
- 適切なGPUを積んだ高性能サーバー。サブスクリプションではなく、一度きりの設備投資。
- 構築プロジェクト。モデルの導入と調整、文書インデックスの作成、アクセス制御の配線。
- 継続的な保守。セキュリティパッチ、モデル更新、ニーズの変化に応じた時折の再調整。
- 社内での所有。あらゆる基幹システムを運用するのと同じく、目を配る担当者を一人決める。
- 問い合わせごとのクラウド請求がない。クラウドでは高くつく利用量が、ハードウェアの支払いが済めば実質無料になる。
これはあなたの事業に合うか?
これは一度きりの話ではありませんでした。同じパターンは、制約が予算ではなくデータの機密性である、あらゆる事務所に当てはまります。法律事務所、医療や健康に近い事業者、セキュリティや防衛に近い業務、金融アドバイザー、営業秘密を抱えるR&Dチーム。AIの助けを求めながらも、データがどこへ行くのかを考えて尻込みしたことがあるなら、あなたこそこのアプローチが想定する対象です。
同様に、もしデータが特に機密性を持たず、単に安心感のために割増料金を払うことになるだけなら、私たちは良いクラウドの選択肢を紹介し、その出費を省いて差し上げます。正しい答えは、どの技術がより印象的に聞こえるかではなく、まったくあなたの義務次第で決まります。最も有益な第一歩はモデルを選ぶことではなく、自社の守秘義務が実際に何を求めているのかについて正直になることなのです。
守秘義務がAI活用の妨げになっていませんか?
データが法律上社外に出せなくても、選択肢はまだあります。しかも、多くの人が思うよりずっと実用的です。何かを構築する義務は一切なしに、オンプレミス構成があなたの義務に見合うかどうか、一緒に見てみましょう。
オンプレミスAIを見てみるよくある質問
オンプレミスAIなら、データは本当に社外に出ませんか?
ローカルで動くモデルは、大手クラウドのものと同じくらい優秀ですか?
オンプレミスAIはとても高価では?
このようなプロジェクトの構築にはどれくらいかかりますか?
稼働後、誰がシステムを保守しますか?
Have a nice day は、中小企業のデジタル化を支援するソフトウェアスタジオです。スライド上だけでなく、日々の業務で本当に機能する自動化・AI・カスタムソフトウェアを提供します。